Cara Kerja Crawl Googlebot: 5 Langkah Praktis untuk Pemula
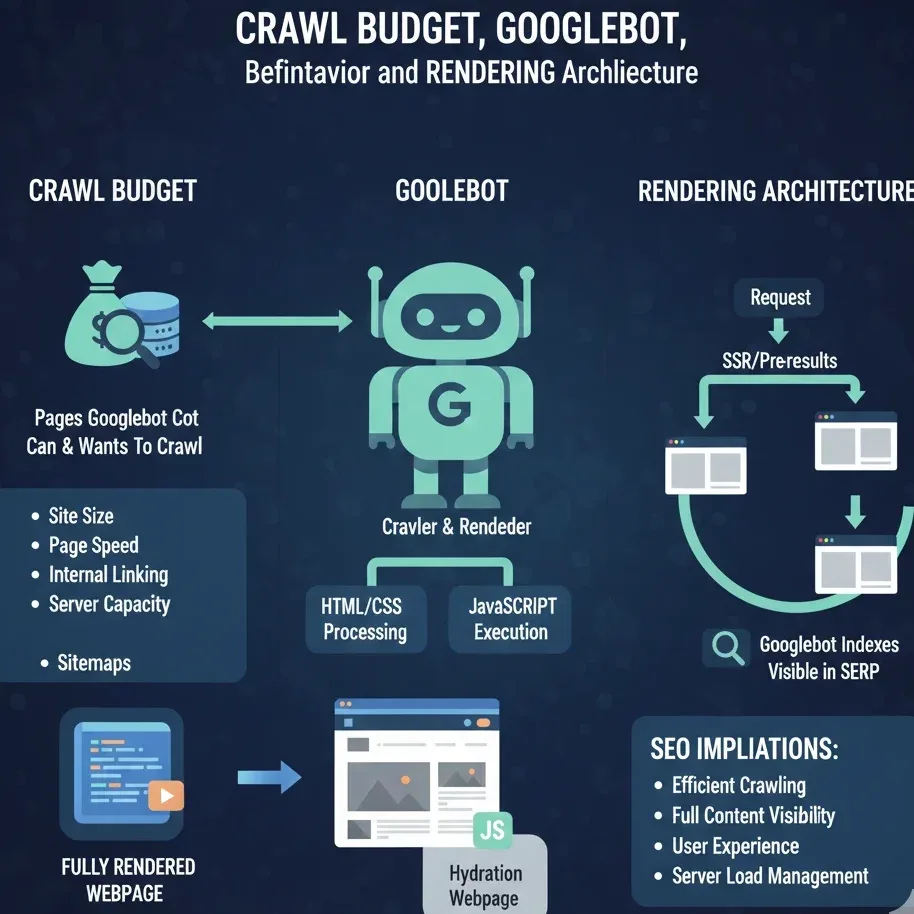
Kalau kamu pernah penasaran kenapa halaman website bisa muncul di halaman pertama Google sementara halaman lain tidak, jawabannya sering kali berakar pada cara kerja crawl googlebot. Ini adalah tahap paling awal dalam seluruh rantai proses pengindeksan, dan justru di sinilah banyak pemilik situs pemula kehilangan jejak.
Bayangkan Googlebot sebagai kurir yang berkeliling kota tanpa henti, mengetuk setiap pintu halaman web, lalu melaporkan apa yang dilihatnya ke kantor pusat. Tanpa kurir ini, halamanmu ibarat toko yang tutup selamanya—rapi, indah, tapi tak pernah dikunjungi siapa pun.
Artikel ini membedah tuntas mekanisme tersebut lewat 5 langkah praktis yang dirancang khusus untuk pemula. Setiap langkah cara kerja crawl googlebot akan kamu jalani dengan contoh konkret, bukan teori melayang. Jadi siapkan secangkir kopi, dan perjalanan sang kurir dari pintu pertama hingga laporan akhirnya.
Mengapa Memahami Crawling Adalah Fondasi SEO yang Sering Diabaikan
Banyak pemula langsung melompat ke riset kata kunci dan backlink, padahal fondasi paling dasar justru sering terlewat: memastikan Googlebot benar-benar bisa masuk dan membaca halaman. Sejujurnya, menurut pengalaman saya mendampingi pemilik situs kecil, kesalahan paling umum bukanlah strategi konten yang lemah—melainkan halaman yang tidak pernah dikunjungi crawler sama sekali. Untuk wawasan dan konteks tambahan, simak juga arsip panduan terkait kami.
Crawling adalah gerbang pertama. Jika gerbang ini tertutup, seluruh upaya optimasi di belakangnya menjadi sia-sia. Kamu bisa menulis artikel sepanjang 5.000 kata dengan riset kata kunci sempurna, tapi jika Googlebot diblokir oleh aturan robots.txt yang salah, halaman itu praktis tidak ada di mata mesin pencari.
Memahami cara kerja crawl googlebot memberi kamu kendali. Kamu tahu kapan harus bersabar, kapan harus turun tangan, dan sinyal apa yang perlu diperbaiki. Ini juga membantu kamu membaca laporan di Google Search Console tanpa bingung—alat yang nantinya menjadi teman harianmu.
Untuk konteks yang lebih luas, kamu bisa merujuk penjelasan resmi di halaman Wikipedia tentang pengoptimalan mesin pencari sebagai bacaan pendamping. Tapi ingat, praktik lapangannya tetap harus kamu jalani sendiri.
Apa Itu Googlebot dan Bagaimana Ia Bekerja di Balik Layar
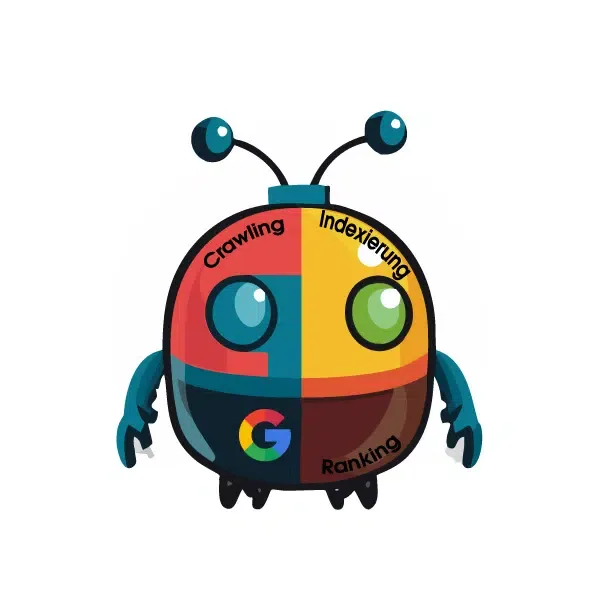
Googlebot cara kerja crawl googlebot adalah program perangkat lunak yang dijalankan Google untuk menjelajahi web. Ia mengunduh halaman, membaca kode HTML-nya, mengikuti tautan yang ditemukan, lalu mengirimkan semua temuan ke sistem pengindeksan. Sederhananya, ia adalah mata dan telinga Google di dunia maya.
Ada dua jenis utama yang perlu kamu kenal. Pertama, Googlebot Desktop yang menyamar sebagai browser komputer. Kedua, Googlebot Smartphone yang kini menjadi prioritas utama karena mayoritas pengguna mengakses lewat ponsel—ini yang disebut mobile-first indexing.
Yang menarik, Googlebot tidak menjelajah secara acak. Ia mengikuti antrean yang disusun berdasarkan otoritas situs, frekuensi pembaruan, dan sinyal lain. Situs yang rutin diperbarui dan dipercaya akan lebih sering dikunjungi, sementara situs baru harus membangun reputasi dari nol.
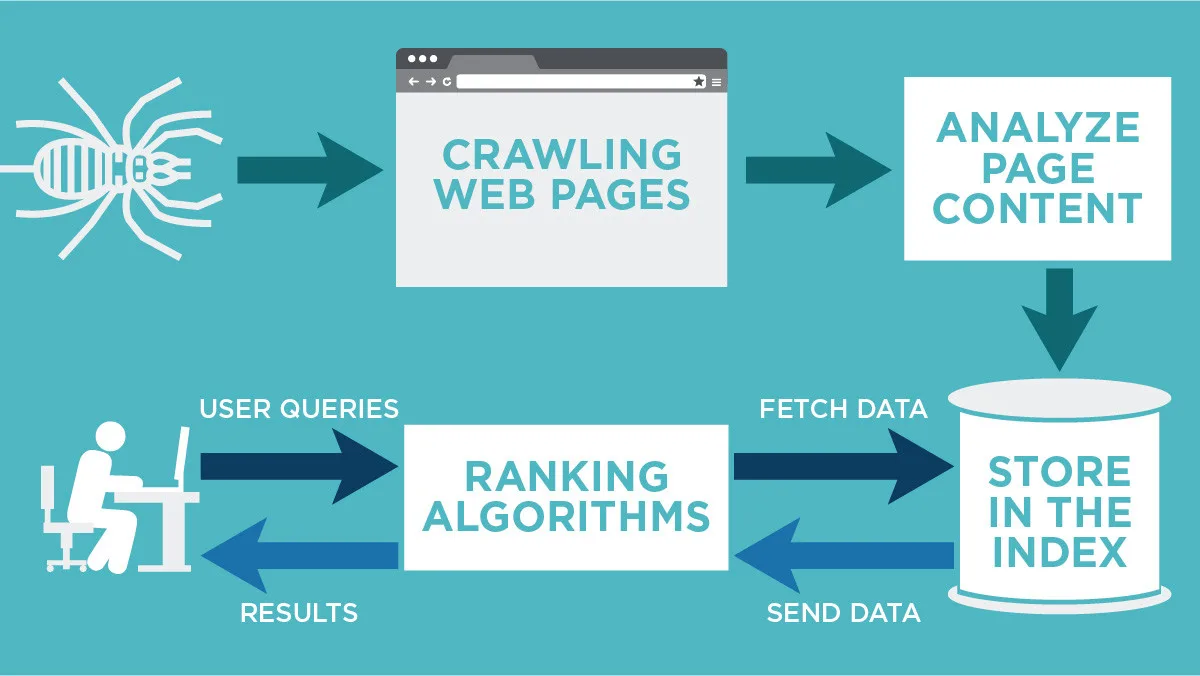
Perbedaan Crawling, Rendering, dan Indexing yang Sering Tertukar
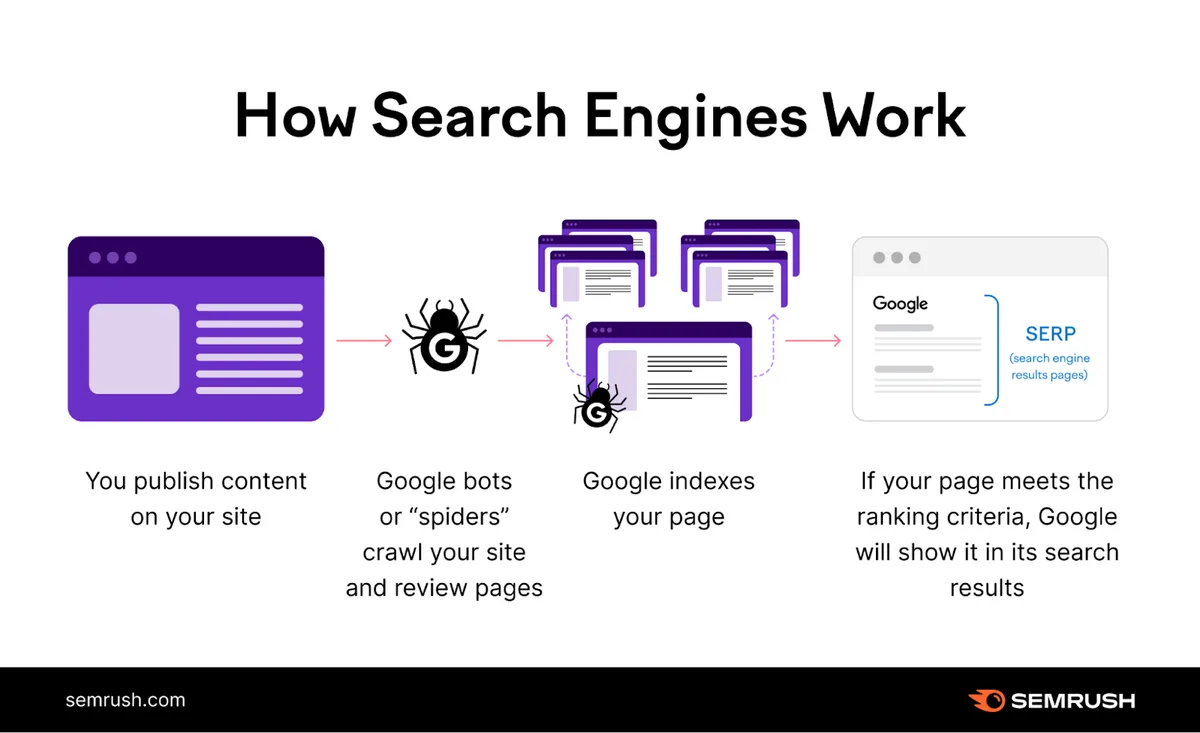
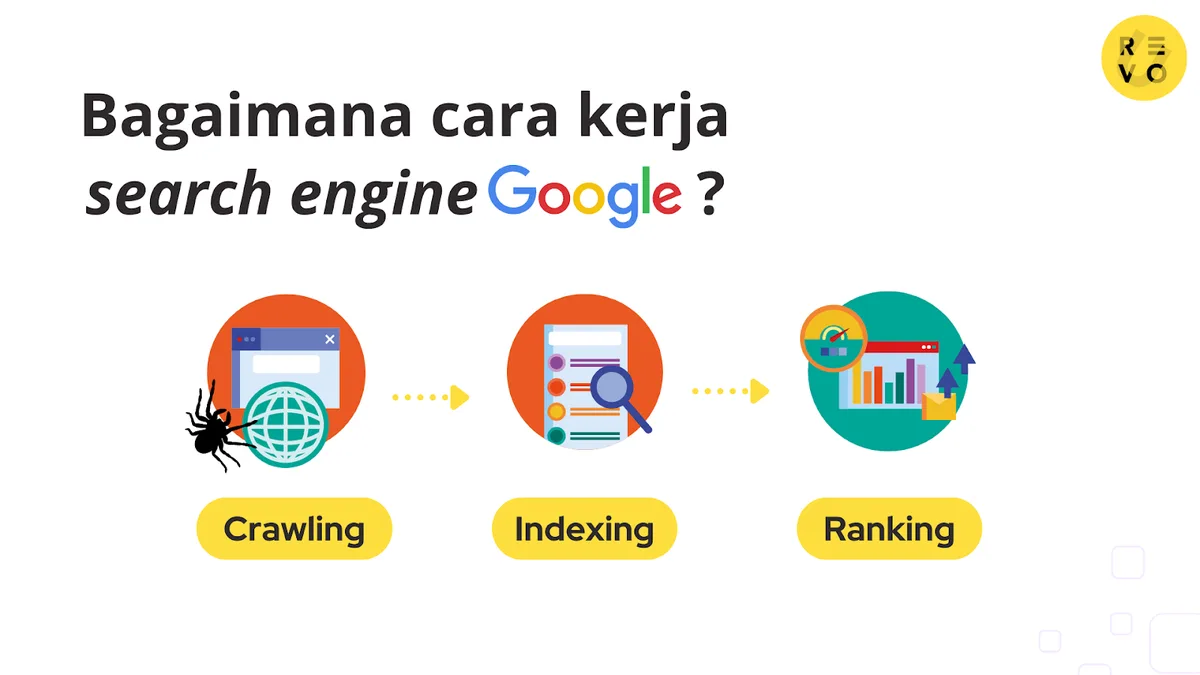
Banyak pemula menganggap ketiga istilah ini sama, padahal perbedaannya krusial. Crawling adalah proses penemuan dan pengambilan halaman. Rendering adalah proses menjalankan JavaScript agar konten dinamis terlihat utuh. Indexing adalah proses menyimpan halaman ke dalam basis data Google.
Bayangkan begini: crawling itu kurir yang mengambil paket, rendering itu proses membuka bungkus paket, dan indexing itu menaruh isi paket ke rak gudang. Kalau kurir cara kerja crawl googlebot tidak pernah datang, rak gudang selamanya kosong. Kalau bungkus tidak terbuka, isinya tak terlihat. Ketiganya harus berjalan berurutan.
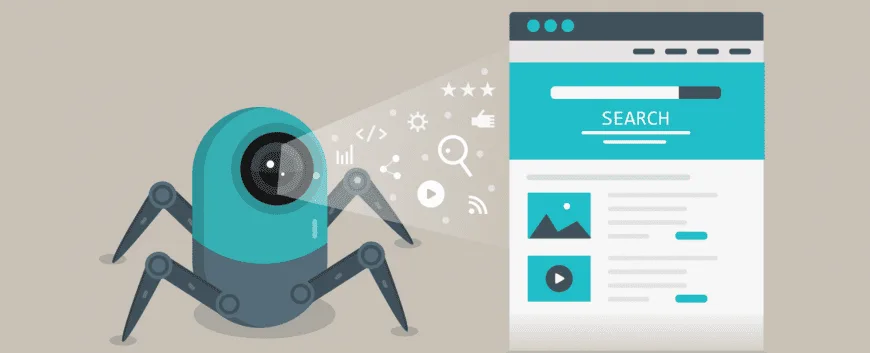
Kesalahpahaman cara kerja crawl googlebot kerap membuat orang panik ketika halaman sudah di-crawl tapi tak kunjung muncul di hasil pencarian. Biasanya masalahnya bukan di tahap crawl, melainkan di rendering atau indexing. Memisahkan ketiganya akan menghemat banyak waktu debugging.
Cara Kerja Crawl Googlebot Step by Step: Gambaran Besar sebelum Masuk ke 5 Langkah
Sebelum membedah 5 langkah praktis, ada baiknya kamu punya peta besar di kepala. Secara garis besar, cara kerja crawl googlebot step by step dimulai dari penemuan URL, pengambilan keputusan, pengunduhan konten, pemrosesan, hingga pelaporan ke sistem pusat. Gambaran ini akan membuat setiap langkah terasa logis, bukan sekadar instruksi teknis.
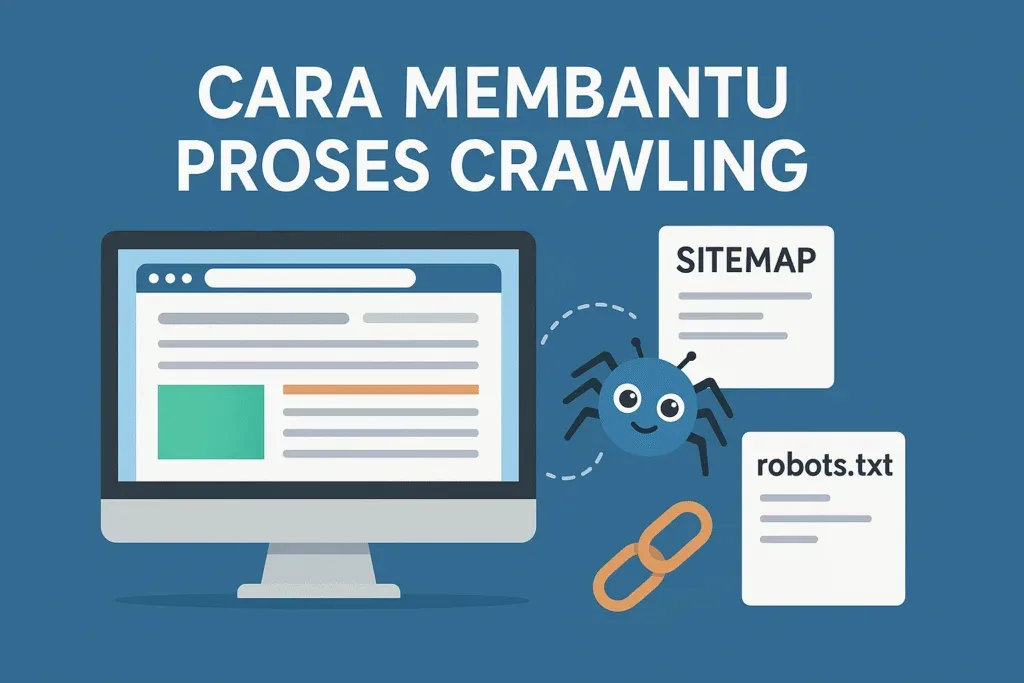
Setiap tahap punya “pintu masuk” dan “titik gagal” sendiri. Dengan mengenali keduanya, kamu bisa mengantisipasi masalah sebelum terjadi—dan lebih cepat memperbaikinya ketika muncul.
| Tahap | Apa yang Terjadi | Alat Pemantau |
|---|---|---|
| Penemuan URL | Crawler menemukan tautan dari sitemap atau halaman lain | Sitemap report |
| Pengunduhan | Googlebot mengambil kode HTML halaman | URL Inspection |
| Rendering | JavaScript dijalankan untuk konten dinamis | Uji rendering |
| Indexing | Konten disimpan ke basis data Google | Halaman terindeks |
| Pelaporan | Hasil dikirim ke Search Console | Laporan crawl |
Tabel di atas menyederhanakan proses yang sebenarnya kompleks, tapi cukup untuk membangun kerangka berpikir. Dari sini, kita akan masuk ke 5 langkah praktis yang bisa langsung kamu eksekusi.
Langkah 1: Memastikan Googlebot Bisa Menemukan Halamanmu
Langkah pertama dalam cara kerja crawl googlebot untuk pemula adalah memastikan halaman benar-benar bisa ditemukan. Ada tiga jalur utama: tautan internal dari halaman lain di situsmu, tautan eksternal dari situs lain, dan sitemap XML. Ketiganya harus kamu siapkan sejak awal.
Tautan internal cara kerja crawl googlebot adalah yang paling mudah dikendalikan dan paling sering diabaikan. Buat struktur navigasi yang rapi agar setiap halaman bisa dijangkau maksimal tiga klik dari halaman utama. Crawler mengikuti tautan seperti pembaca yang penasaran—semakin mudah jalannya, semakin cepat ia tiba.
Sitemap XML berfungsi sebagai peta resmi situsmu. Kirimkan melalui Google Search Console agar Googlebot tahu URL mana saja yang perlu dikunjungi. Jangan lupa memperbarui sitemap setiap kali menambah halaman baru, karena sitemap usang hanya membuang energi crawler.
Mengatur Sitemap XML yang Rapi dan Mudah Dibaca Crawler
Aturan pertama: jangan menaruh lebih dari 50.000 URL dalam satu sitemap. Jika situsmu membesar, pecah ke beberapa file dan gunakan index sitemap sebagai penghubung. Batas ukuran file cara kerja crawl googlebot juga sekitar 50 MB, jadi kompresi dengan format gzip sangat membantu.
Pastikan setiap URL yang tercantum adalah versi final—bukan halaman yang dialihkan, bukan halaman error, dan bukan URL dengan parameter sampah. Satu-satunya tanda baca yang mengganggu crawl adalah URL kotor yang membingungkan.
Perbarui tanggal lastmod secara akurat. Banyak orang mengisi tanggal palsu agar terlihat aktif, tapi ini justru merusak kepercayaan crawler. Kalau Googlebot datang dan mendapati konten tak berubah, kunjungan berikutnya akan lebih jarang. Konsistensi lebih berharga daripada angka tanggal yang ramai.
Langkah 2: Memeriksa Robots.txt dan Meta Robots sebelum Terlambat
File robots.txt cara kerja crawl googlebot adalah rambu lalu lintas sekaligus pagar pengaman. Di sinilah kamu memberi tahu Googlebot bagian mana yang boleh dan tidak boleh dijelajahi. Masalahnya, satu karakter salah seperti garis miring yang hilang bisa memblokir seluruh situs dari pengindeksan.
Periksa kembali apakah kamu menulis Disallow: / secara tidak sengaja. Perintah ini berarti “jangan crawl apa pun”, dan itu mimpi buruk yang sering terjadi pada situs hasil migrasi server. Cukup satu baris keliru, dan halamanmu lenyap dari radar.
Selain robots.txt, ada juga tag meta robots di level halaman. Tag noindex memerintahkan Googlebot untuk tidak memasukkan halaman ke indeks, meski ia tetap boleh crawl. Kombinasi yang paling berbahaya adalah ketika robots.txt memblokir crawl sementara meta noindex memblokir indeks—crawler tak bisa membaca instruksi karena tak diizinkan masuk.
Aturan Sederhana Menyusun Robots.txt untuk Pemula
Gunakan pendekatan minimalis. Izinkan semuanya secara default, lalu blokir hanya folder yang memang sensitif seperti area admin, keranjang belanja, atau halaman pencarian internal. Semakin sederhana, semakin kecil peluang salah konfigurasi.
Selalu cantumkan lokasi sitemap di baris terakhir robots.txt. Ini memberi petunjuk tambahan bagi crawler yang baru pertama kali datang. Setelah mengubah file, uji langsung melalui alat uji robots.txt di Search Console agar kamu melihat simulasi perintah sebelum diterapkan.
Ingat, perubahan robots.txt cara kerja crawl googlebot tidak langsung berlaku. Googlebot bisa membutuhkan waktu untuk membaca versi terbaru, terutama jika cache-nya masih menyimpan versi lama. Bersabarlah beberapa hari, lalu periksa laporan crawl untuk memastikan perubahan sudah terdeteksi.
Langkah 3: Mengoptimalkan Kecepatan Respons Server dan Konten
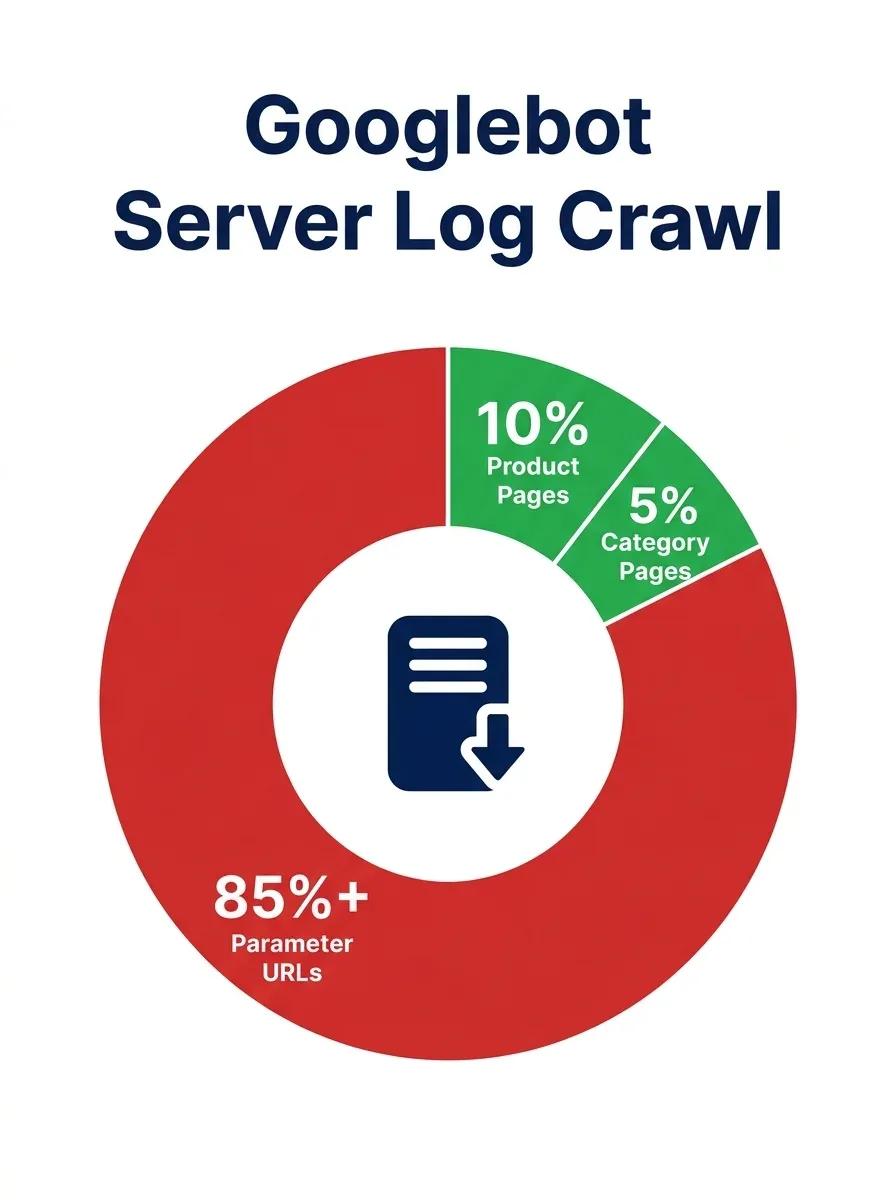
Setelah gerbang terbuka, Googlebot akan mengetuk pintu halamanmu. Di sinilah kecepatan respons server menentukan seberapa ramah sambutan yang kamu berikan. Server yang lambat membuat crawler menunggu, dan waktu tunggu ini masuk ke dalam anggaran crawl—batas jumlah halaman yang sanggup diproses Googlebot dalam satu kunjungan.
Menurut pengalaman menangani situs dengan hosting murah, waktu respons di atas 1 detik sudah cukup membuat crawler mengurangi frekuensi kunjungan. Solusinya cara kerja crawl googlebot bukan selalu upgrade paket, tapi bisa dimulai dari caching, kompresi gambar, dan mengurangi skrip pihak ketiga yang tidak perlu.
Konten juga berpengaruh. Halaman yang terlalu berat dengan animasi dan video autoplay membuat proses rendering lebih lama. Prioritaskan konten inti agar bisa dibaca lebih dulu, lalu biarkan elemen dekoratif menyusul. Prinsip progressive enhancement sangat relevan di sini.
Ukuran halaman idealnya di bawah 100 KB untuk HTML murni, dan total aset di bawah 2 MB. Jika melebihi, pertimbangkan untuk memecah halaman atau mengompresi gambar ke format modern seperti WebP. Kecil bukan berarti jelek—justru sering lebih cepat dan lebih disukai crawler.
Langkah 4: Memantau Proses Crawling Melalui Google Search Console
Setelah semua disiapkan, tibalah saatnya memantau. Google Search Console adalah dasbor utama yang menunjukkan bagaimana cara kerja crawl googlebot pada situsmu. Di sana kamu bisa melihat halaman mana yang berhasil di-crawl, mana yang error, dan berapa kali crawler datang.
Fitur URL Inspection cara kerja crawl googlebot adalah teman terbaikmu untuk pengecekan individual. Tempel URL, lalu lihat statusnya: apakah sudah di-crawl, kapan terakhir dikunjungi, dan apakah ada masalah rendering. Fitur ini memberi jawaban langsung tanpa perlu menebak-nebak.
Laporan Crawl Stats menunjukkan tren kunjungan crawler dari waktu ke waktu. Lonjakan atau penurunan drastis biasanya menandakan perubahan di situs—entah itu pembaruan besar, migrasi server, atau masalah teknis yang belum disadari.
Membaca Laporan Crawl Stats tanpa Panik
Angka “host status” mungkin tampak menakutkan, tapi sebenarnya sederhana. Status 200 berarti normal, 301 berarti pengalihan permanen, dan 404 berarti halaman tidak ditemukan. Error 5xx perlu perhatian lebih karena menandakan masalah di sisi server.
Jangan panik jika jumlah crawl turun tiba-tiba. Sering kali ini hanya efek musiman atau perubahan algoritma yang memengaruhi frekuensi. Yang penting adalah memastikan halaman penting tetap ter-crawl, dan tidak ada error kritis yang menumpuk.
Ekspor data crawl ke spreadsheet jika kamu ingin analisis lebih dalam. Melacak pola selama beberapa minggu akan menunjukkan halaman mana yang paling diperhatikan Googlebot, dan halaman mana yang perlu didorong melalui tautan internal tambahan.
Langkah 5: Membangun Siklus Crawl yang Sehat dan Berkelanjutan
Langkah terakhir bukan tentang satu kali perbaikan, melainkan tentang menjaga ritme. Cara kerja crawl googlebot terbaru menekankan pentingnya konsistensi—situs yang diperbarui rutin akan lebih sering dikunjungi, sementara situs stagnant perlahan ditinggalkan.
Tetapkan jadwal pembaruan konten yang realistis. Tidak perlu setiap hari jika tidak sanggup; satu artikel berkualitas setiap dua minggu sudah cukup untuk membangun sinyal aktivitas. Yang penting adalah kamu benar-benar memelihara konten lama, bukan hanya menambah yang baru.
Perbaiki tautan rusak secara berkala. Crawler yang menemukan terlalu banyak tautan mati akan menganggap situsmu kurang terawat, dan frekuensi kunjungan bisa menurun. Alat gratis seperti pemeriksa tautan bisa membantumu menemukan masalah ini dalam hitungan menit.
Terakhir, pantau perubahan algoritma utama Google. Setiap kali ada pembaruan besar, cara kerja crawl googlebot bisa sedikit bergeser—misalnya prioritas pada pengalaman halaman atau kecepatan mobile. Tetap fleksibel dan siap menyesuaikan.
Tutorial Kerja Crawl Googlebot untuk Pemula: Menyusun Rutinitas Pemeriksaan Mingguan
Teori tanpa rutinitas akan cepat menguap. Karena itu, mari kita rangkai tutorial kerja crawl googlebot yang bisa kamu jalankan setiap minggu dengan waktu kurang dari 30 menit. Rutinitas ini dirancang untuk pemula, jadi tidak ada alat berbayar atau pengaturan rumit.
Mulai dengan membuka Search Console dan memeriksa tiga laporan utama: Page Indexing, Crawl Stats, dan Sitemap. Catat jumlah halaman terindeks dan bandingkan dengan minggu sebelumnya. Lonjakan atau penurunan tajam adalah sinyal pertama yang perlu diselidiki.
Selanjutnya, buka URL Inspection untuk satu halaman penting dan satu halaman acak. Ini memberi gambaran cepat apakah crawler masih aktif mengunjungi situsmu. Jika ditemukan halaman error, langsung catat dan perbaiki sebelum menumpuk.
Terakhir, perbarui sitemap dan pastikan tautan internal baru sudah terhubung. Simpan catatan singkat tentang perubahan yang kamu lakukan, agar debugging ke depan lebih mudah. Konsistensi kecil ini, jika dilakukan rutin, akan membangun fondasi crawl yang kuat tanpa terasa membebani.
Kesalahan Umum Pemula dalam Menangani Crawling dan Cara Menghindarinya
Kesalahan pertama cara kerja crawl googlebot adalah memblokir crawler tanpa sadar melalui robots.txt atau tag noindex yang tertinggal dari masa pengembangan. Solusinya sederhana: buat daftar periksa sebelum situs diluncurkan, dan periksa sekali lagi seminggu setelah peluncuran.
Kesalahan kedua adalah menumpuk tautan internal ke satu halaman saja, sementara halaman lain terabaikan. Crawler mengikuti distribusi otoritas halaman, jadi pastikan setiap halaman baru mendapat minimal satu tautan internal dari halaman yang sudah kuat.
Kesalahan ketiga cara kerja crawl googlebot adalah mengabaikan laporan error 5xx. Server yang sering gagal merespons akan mengurangi frekuensi kunjungan crawler, dan dalam kasus ekstrem bisa membuat halaman dihapus dari indeks. Pantau kondisi server secara berkala, apalagi setelah perubahan konfigurasi.
Kesalahan keempat cara kerja crawl googlebot adalah mengganti URL secara massal tanpa pengalihan 301. Ini menciptakan tautan mati dalam jumlah besar dan memperlambat proses crawl. Selalu siapkan pengalihan permanen setiap kali URL berubah, dan pastikan pengalihan mengarah ke halaman yang relevan.
Kesalahan kelima adalah percaya bahwa semua konten pasti ter-crawl cepat. Padahal situs baru butuh waktu membangun kepercayaan. Kesabaran bukan tanda kelemahan, melainkan bagian dari cara kerja crawl googlebot yang wajar.
Pertanyaan yang Sering Muncul Seputar Crawling Googlebot
Berikut pembahasan mendalam dan aspek penting seputar bagian ini:
Berapa Lama Googlebot Butuh Waktu untuk Meng-crawl Halaman Baru?
Tidak ada angka pasti, tapi untuk situs baru biasanya berkisar dari beberapa hari hingga beberapa minggu. Situs yang lebih tua dan sering diperbarui bisa di-crawl dalam hitungan jam. Faktor penentu utamanya cara kerja crawl googlebot adalah otoritas situs, kecepatan server, dan seberapa sering konten diperbarui.
Untuk mempercepat, kirim URL langsung melalui URL Inspection di Search Console. Ini bukan jaminan instan, tapi setidaknya memberi sinyal bahwa halaman tersebut penting. Jangan mengirim ulang setiap hari—itu hanya membuang sumber daya.
Apakah Crawling Sama dengan Pengindeksan?
Bukan. Crawling cara kerja crawl googlebot adalah proses penemuan dan pengambilan halaman, sementara pengindeksan adalah proses menyimpannya ke basis data Google. Sebuah halaman bisa berhasil di-crawl tapi tidak diindeks karena dianggap tidak berkualitas atau duplikat. Keduanya perlu jalur sendiri.
Karena itu, memantau hanya “apakah sudah di-crawl” tidak cukup. Kamu juga perlu memastikan halaman benar-benar muncul di indeks melalui laporan Page Indexing. Halaman yang ter-crawl tapi tidak terindeks biasanya butuh perbaikan konten, bukan perbaikan teknis.
Bagaimana Cara Memeriksa Apakah Googlebot Bisa Mengakses Halaman Saya?
Gunakan fitur URL Inspection di Search Console, lalu lihat bagian “Live Test”. Fitur ini mensimulasikan kunjungan Googlebot secara nyata dan melaporkan apa yang dilihatnya. Jika berhasil, kamu akan melihat status 200 atau indikasi crawl yang sukses.
Alternatifnya, gunakan alat uji robots.txt untuk memeriksa apakah URL tertentu diblokir. Kedua alat ini gratis dan cukup akurat untuk kebutuhan pemula. Manfaatkan keduanya secara bergantian sesuai kebutuhan pemeriksaan.
Mengapa Halaman Penting Saya Jarang Dikunjungi Crawler?
Beberapa penyebab paling umum: halaman tidak ditautkan dari mana pun, tautan internal terlalu dalam, server lambat, atau sitemap tidak mencantumkan URL tersebut. Periksa satu per satu, mulai dari tautan internal karena paling mudah diperbaiki.
Selain itu, pastikan tidak ada tag noindex tersembunyi dari sisa pengembangan. Sering kali masalahnya sederhana, hanya tertutup oleh asumsi bahwa “semua sudah diatur”. Pemeriksaan manual yang teliti jauh lebih efektif daripada menebak.
Apakah Crawling Terpengaruh oleh Kecepatan Website?
Sangat berpengaruh. Server yang lambat membuat Googlebot menunggu, dan waktu tunggu ini memakan anggaran crawl. Semakin kecil anggaran, semakin sedikit halaman yang bisa diproses dalam satu kunjungan. Efeknya terasa pada situs besar dengan ribuan URL.
Karena itu, optimasi kecepatan bukan sekadar soal pengalaman pengguna, tapi juga soal efisiensi crawl. Kompresi gambar, caching, dan pemilihan hosting yang tepat adalah investasi jangka panjang yang berdampak langsung pada cara kerja crawl googlebot.
Menghubungkan Crawling dengan Strategi Konten Jangka Panjang
Crawling bukan tujuan akhir, melainkan pintu menuju pengindeksan dan peringkat. Karena itu, seluruh usaha di 5 langkah tadi baru akan berbuah jika kontenmu benar-benar menjawab kebutuhan pembaca. Crawler yang rajin datang ke halaman berkualitas akan membawa hasil lebih baik daripada crawler yang datang ke halaman kosong.
Sejalan dengan cara kerja crawl googlebot, pikirkan situsmu sebagai bagian dari klaster topik yang lebih besar. Artikel tentang crawling ini adalah sub-topik dari topik induk yang lebih luas, misalnya pengoptimalan teknis SEO. Ketika kamu membangun beberapa artikel yang saling terhubung, otoritas topikmu menguat dan crawler akan lebih sering datang.
Sub-topik turunan yang layak kamu siapkan berikutnya meliputi pengindeksan halaman, struktur data terstruktur, dan audit teknis dasar. Masing-masing memiliki peran berbeda tapi saling menguatkan, persis seperti pondasi dalam rumah—tak terlihat, tapi menentukan seberapa tinggi bangunannya bisa berdiri.
Jujur saja, banyak pemilik situs kecil berhenti di tahap “sudah di-crawl” dan merasa tugas selesai. Padahal di situlah justru pekerjaan menarik dimulai: memastikan halaman benar-benar berguna, cepat diakses, dan relevan dengan pencarian. Crawling hanyalah awal perjalanan, bukan garis akhir.
Kalau kamu bisa membangun rutinitas mingguan yang konsisten, menyusun sitemap rapi, dan menjaga kecepatan server, maka cara kerja crawl googlebot akan bekerja untukmu—bukan melawanmu. Dan di situlah keunggulan kompetitif yang sesungguhnya terbentuk, jauh sebelum kamu memikirkan kata kunci yang lebih rumit.