Screaming Frog website crawler adalah salah satu perangkat paling sering disebut ketika orang berbicara soal audit teknis SEO, dan panduan screaming frog website crawler lengkap ini hadir untuk membedah alat itu dari nol sampai mahir.
Jujur saja, banyak yang pertama kali membukanya lalu langsung menutupnya lagi karena bingung harus mengklik apa. Padahal, di balik antarmuka yang terlihat seperti spreadsheet desktop itu, tersimpan kemampuan membongkar isi situs sampai ke lapisan paling dalam.
Artikel ini adalah panduan screaming frog website crawler terbaru yang saya susun berdasarkan pengalaman langsung menangani audit situs mulai dari blog kecil hingga e-commerce dengan puluhan ribu URL. Kita akan bahas cara pasang, cara konfigurasi, cara membaca laporan, sampai cara mengubah temuan crawl menjadi daftar pekerjaan yang bisa dieksekusi tim developer. Sebagai rujukan tambahan, Anda dapat membaca dokumentasi lengkap seputar screaming frog website crawler di ensiklopedia resmi.
Kalau Anda selama ini cuma tahu alat ini untuk “cek broken link”, bersiaplah mengubah pandangan. screaming frog website crawler lebih mirip pisau lipat serbaguna: fungsinya sebanyak kebutuhan teknis situs Anda.
Mengenal Screaming Frog Website Crawler Lebih Dekat
Sebelum masuk ke teknis, kita perlu menyamakan persepsi dulu. Screaming Frog website crawler adalah aplikasi desktop yang menjelajahi seluruh halaman situs dengan meniru cara kerja bot mesin pencari, lalu mengumpulkan data mentah dari setiap URL yang ditemukan.
Alat screaming frog website crawler dikembangkan oleh tim Screaming Frog dari Inggris, dan namanya konon diambil dari kebiasaan aplikasi ini yang “memakan” halaman web satu per satu—mirip katak yang menyambar serangga. Detail menarik seperti ini jarang disinggung, padahal membantu kita memahami logika kerjanya.
Karena berbasis desktop, crawler screaming frog website crawler tidak bergantung pada server hosting Anda. Artinya, crawl sebesar apa pun tidak akan membebani resource website, hanya memakai bandwidth dan RAM komputer Anda sendiri.
Kenapa Alat Ini Jadi Standar Industri Audit SEO
Ada alasan kuat mengapa hampir semua konsultan SEO teknis menyimpan alat screaming frog website crawler di dock komputernya. Pertama, kemampuannya memindai ribuan URL sekaligus dengan kecepatan yang bisa diatur sesuai kebutuhan.
Kedua, hasil crawl disajikan dalam tabel yang bisa difilter, diurutkan, dan diekspor ke CSV. Ini kelihatan sederhana, tapi jadi penyelamat ketika harus menyerahkan laporan ke klien atau tim developer dari departemen lain.
Ketiga, ekosistem integrasinya luas. Alat ini bisa tersambung ke Google Analytics, Google Search Console, PageSpeed Insights, hingga Ahrefs dan Moz. Data dari berbagai sumber itu lantas digabung dalam satu tampilan, sehingga analisis becomes jauh lebih efisien.
Cara Kerja Screaming Frog Website Crawler di Balik Layar
Memahami mekanisme internal alat ini akan membuat Anda lebih percaya diri saat mengatur konfigurasi. Semuanya dimulai dari satu seed URL yang Anda masukkan di kolom paling atas.
Dari URL itu, crawler mengunduh HTML, mem-parsing isinya, lalu mengekstrak semua tautan yang ditemukan—baik internal maupun eksternal. Tautan internal kemudian dimasukkan ke antrean untuk dikunjungi berikutnya, dan proses screaming frog website crawler ini berulang sampai batas kedalaman atau jumlah URL yang Anda tentukan tercapai.
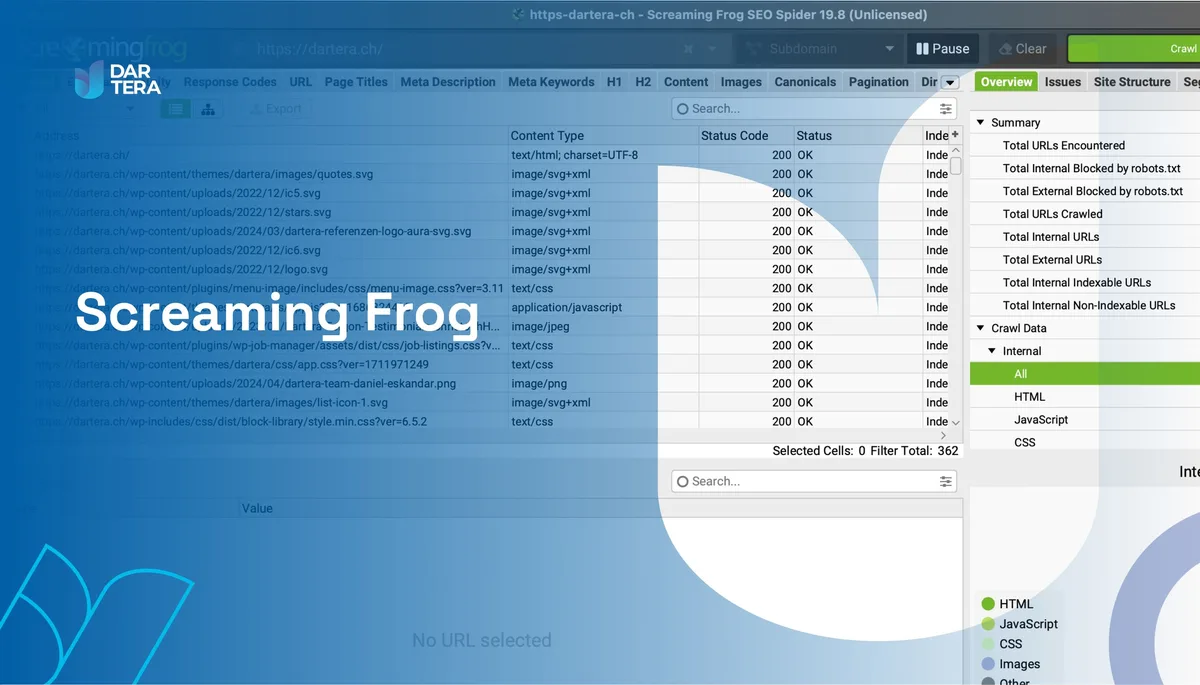
Setiap respons server dicatat: kode status HTTP, ukuran halaman, waktu respons, header, sampai meta robots. Semua informasi itu berkumpul dalam tab-tab terpisah yang bisa Anda telusuri satu per satu.
Perbedaan Mode Spider dan Mode List
Panduan screaming frog website crawler yang baik harus menjelaskan dua mode operasi ini, karena banyak pengguna pemula mengabaikannya. Mode Spider adalah mode standar: crawler menjelajah dari satu titik awal dan mengikuti tautan yang ditemukan.
Mode List, sebaliknya, menerima daftar URL dari luar—misalnya hasil ekspor dari sitemap atau Search Console—lalu memeriksa satu per satu tanpa mengikuti tautan lebih jauh. Mode ini sangat berguna ketika Anda ingin mengaudit sekumpulan URL spesifik tanpa terjebak menjelajah seluruh situs.
Dalam praktiknya, saya sering memakai kombinasi keduanya: Spider untuk pemetaan menyeluruh, List untuk verifikasi setelah perbaikan dilakukan.
Langkah Instalasi dan Persiapan Awal
Proses pemasangan alat ini tidak rumit, tapi ada beberapa hal yang perlu disiapkan agar crawl pertama tidak berakhir dengan error bikin frustrasi.
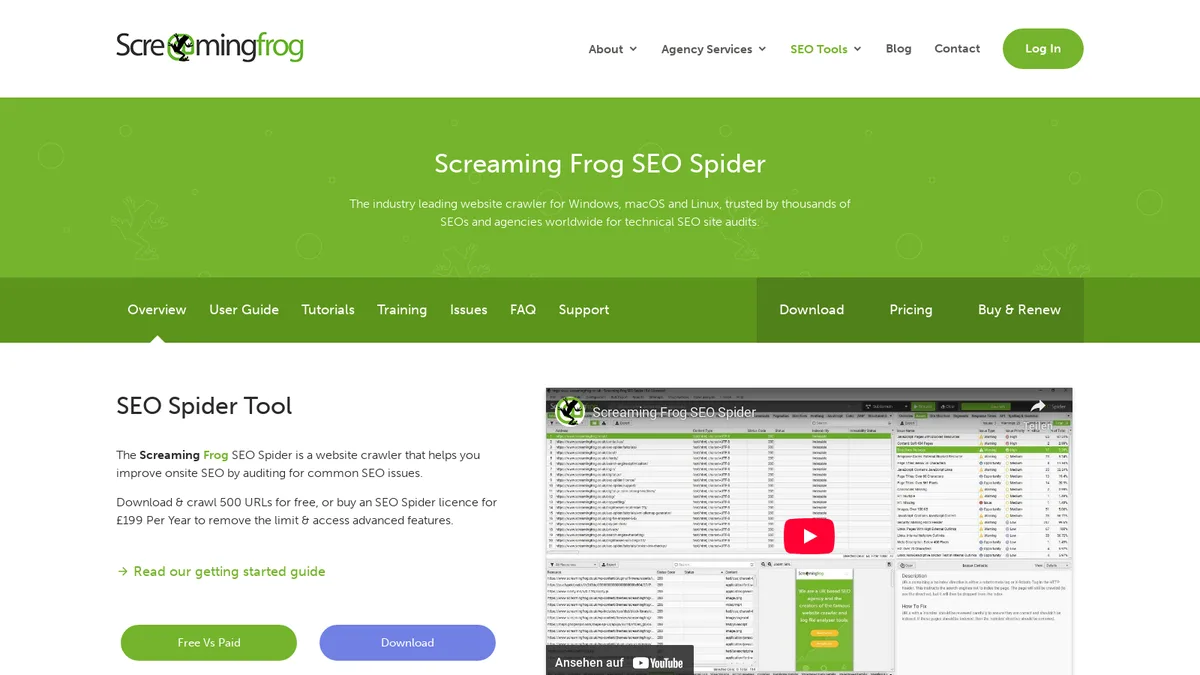
- Unduh installer dari situs resmi Screaming Frog. Tersedia untuk Windows, macOS, dan Ubuntu. Hindari mengunduh dari situs pihak ketiga karena risiko malware. Contoh praktis: simpan file installer di folder khusus alat SEO agar mudah dilacak versinya.
- Periksa kebutuhan Java. Versi terbaru sudah membawa runtime sendiri, tapi versi lawas membutuhkan Java terpasang. Kalau aplikasi gagal membuka, cek dulu apakah Java tersedia di sistem Anda.
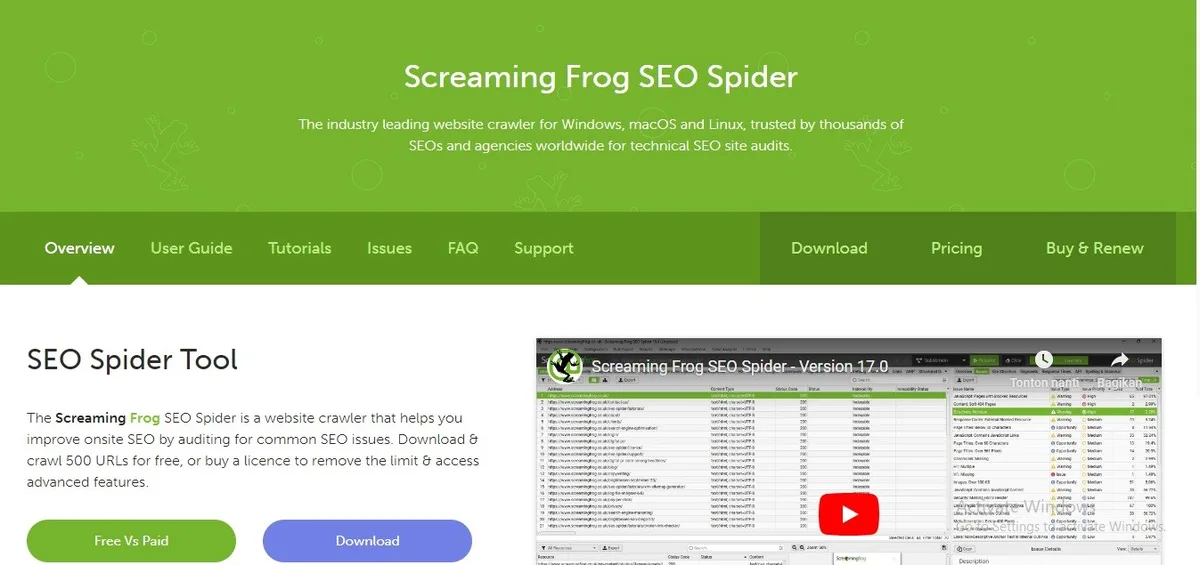
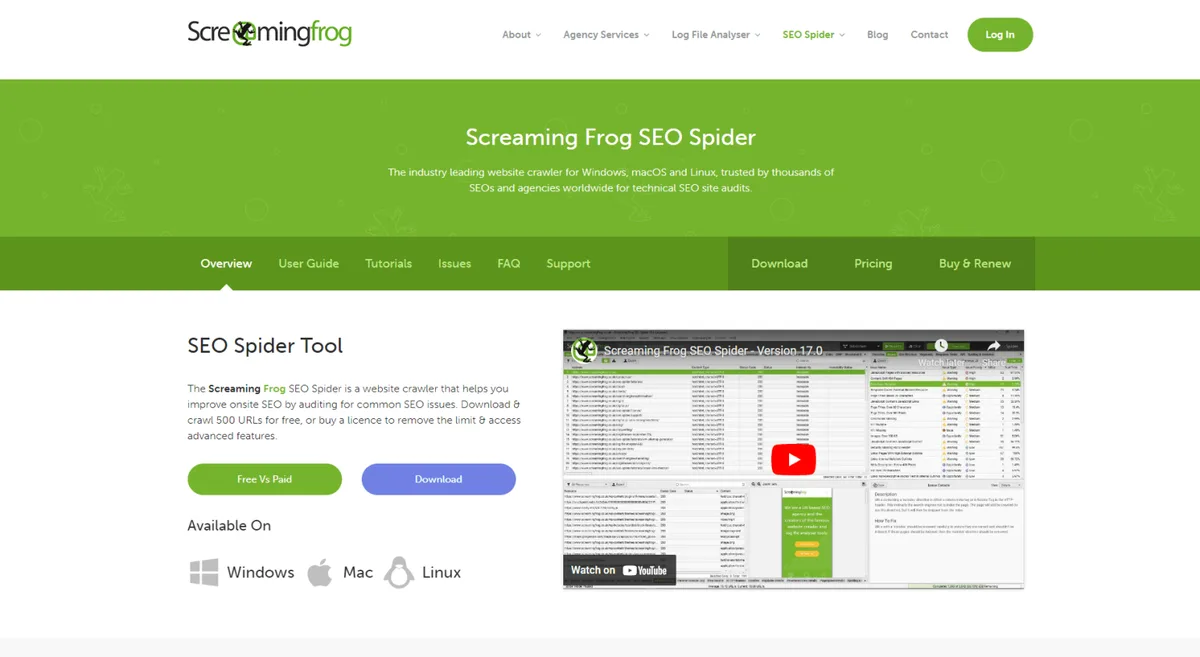
- Siapkan lisensi. Versi gratis membatasi crawl hingga 500 URL per sesi. Untuk situs besar, lisensi berbayar diperlukan—dan kabar baiknya, harganya kompetitif langsung dari produsen, jadi tidak ada markup perantara.
- Alokasikan RAM yang cukup. Crawl 100.000 URL butuh memori besar. Tutup aplikasi berat lain saat crawl berjalan agar tidak crash di tengah jalan.
- Catat baseline data. Sebelum crawl, ekspor data Search Console atau Analytics sebagai pembanding. Contoh: simpan daftar URL dengan impresi tinggi untuk dicek statusnya setelah crawl.
Setelah semua siap, buka aplikasi dan Anda akan disambut antarmuka dengan kolom URL di bagian atas. Di sanalah petualangan dimulai.
Konfigurasi Crawl yang Tepat sebelum Menekan Tombol Start
Inilah bagian yang paling sering dilewati pemula, padahal justru paling menentukan kualitas hasil. Menekan tombol Start tanpa mengatur apa pun sama seperti berangkat road trip tanpa menentukan tujuan.
Buka menu Configuration lalu Crawl Config. Di sini Anda bisa menentukan batas crawl, kecepatan, user agent, dan cara crawler memperlakukan tautan eksternal serta parameter URL.
Mengatur Batas dan Kecepatan Crawl
Untuk situs kecil, biarkan batas crawl di angka default. Tapi jika situs Anda punya puluhan ribu URL, aturlah limit agar crawl selesai dalam waktu wajar.
Kecepatan crawl diukur dalam URI per detik. Menaikkan angka ini mempercepat proses, tapi berisiko memicu rate limiting dari server. Saran praktis: mulai dari angka rendah, pantau respons server, lalu naikkan perlahan.
Pada situs dengan WAF ketat, terkadang crawl malah diblokir. Solusinya, turunkan kecepatan atau tambahkan user agent khusus yang sudah diizinkan oleh tim server.
Menyaring Parameter dan Duplikasi URL
URL dengan parameter seperti ?utm_source atau ?sort=price bisa membuat hasil crawl membengkak tanpa nilai tambah. Di tab Crawl Config, aktifkan opsi untuk mengabaikan parameter tertentu.
Ada juga opsi untuk mendeteksi halaman duplikat berdasarkan checksum konten. Fitur ini menyelamatkan Anda dari mengaudit ratusan halaman yang isinya sama persis hanya karena URL-nya berbeda.
Menurut pengalaman, kombinasi kedua pengaturan ini bisa memangkas hasil crawl hingga 40 persen pada situs e-commerce, sehingga laporan jadi jauh lebih fokus.
Membaca Tab-Tab Laporan Screaming Frog Website Crawler
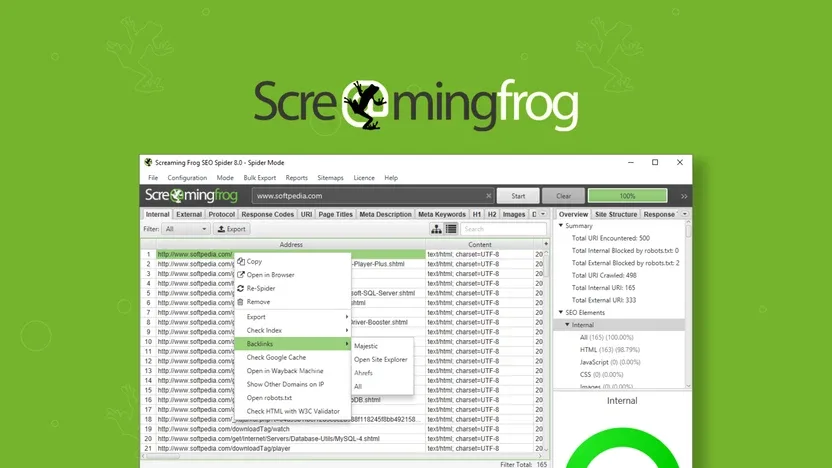
Begitu crawl selesai, layar akan dipenuhi tab berisi ribuan baris data. Di sinilah panduan screaming frog website crawler benar-benar terasa manfaatnya, karena tanpa pemahaman tab-tab ini, data mentah cuma jadi angka tanpa arti.
Setiap tab mewakili kategori masalah atau kelompok entitas. Kita akan bahas satu per satu yang paling penting untuk audit teknis harian.
Tab Internal: Jantung Pemetaan Situs
Tab Internal memuat semua URL yang berada di domain Anda. Dari sini Anda bisa melihat status code, kedalaman crawl, jumlah tautan masuk internal, dan ukuran halaman.
Filter yang paling sering saya pakai adalah Response Codes Client Error (4xx). Di situ akan muncul daftar halaman yang tidak bisa diakses, plus halaman mana saja yang masih menautkannya.
Data tautan masuk itu emas: Anda tahu persis halaman mana yang harus diubah agar broken link hilang dari peredaran.
Tab External dan Security
Tab External menampilkan semua tautan keluar yang ditemukan crawler. Anda bisa memeriksa apakah ada tautan ke situs berbahaya, atau memastikan tautan afiliasi memakai atribut yang benar.
Tab Security, yang sering terlewat, membantu mendeteksi apakah situs Anda punya masalah HTTPS campuran atau sertifikat kedaluwarsa. Untuk situs yang baru migrasi ke HTTPS, tab ini wajib dibuka.
Tab Directives dan Hreflang
Directives memberi tahu Anda halaman mana yang di-noindex, diblokir robots.txt, atau punya canonical yang menunjuk ke URL lain. Ini krusial untuk memastikan halaman penting tidak “hilang” dari indeks tanpa sengaja.
Sementara tab Hreflang membantu situs multibahasa. Alat ini akan menandai kalau ada hreflang yang salah tulis, tidak konsisten, atau menunjuk ke halaman yang tidak ada.
Audit SEO On-Page dengan Bantuan Crawler
Selain masalah teknis, Screaming Frog website crawler juga bisa dipakai untuk mengecek elemen on-page secara massal. Ini menghemat waktu luar biasa dibandingkan memeriksa halaman satu per satu secara manual.
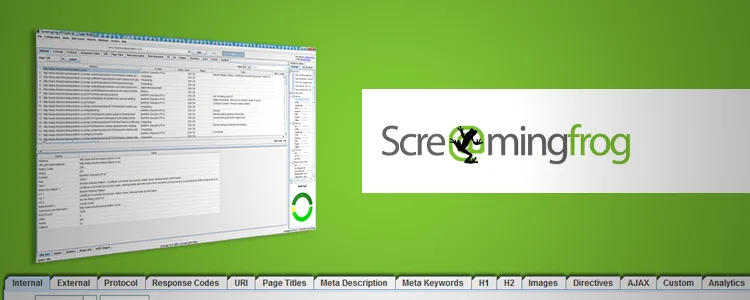
Setelah crawl selesai, buka tab Page Titles. Di situ terlihat judul setiap halaman, panjangnya, dan apakah ada yang duplikat atau kosong.
Lanjut ke tab Meta Description untuk memeriksa panjang dan keunikannya. Alat ini memberi tanda merah pada deskripsi yang terlalu pendek, terlalu panjang, atau hilang sama sekali.
Untuk heading, buka tab H1 dan H2. Anda bisa langsung melihat halaman mana yang punya lebih dari satu H1—kesalahan klasik yang masih sering ditemukan di situs berita dan toko online.
Menemukan Konten Tipis dan Halaman Orphan
Tab Content menyediakan data jumlah kata per halaman. Dari sini Anda bisa memfilter halaman dengan kata di bawah ambang tertentu, lalu memutuskan apakah perlu diperkaya atau digabung dengan halaman lain.
Untuk halaman orphan—halaman yang tidak punya tautan internal sama sekali—gunakan kombinasi crawl dengan data sitemap. Bandingkan daftar URL di sitemap dengan hasil tab Internal; selisihnya adalah kandidat orphan page.
Halaman seperti ini biasanya luput dari perhatian karena tidak muncul di navigasi. Padahal, kalau isinya berkualitas, ia berpotensi mendatangkan trafik organik yang signifikan.
Analisis Gambar dan Aset Media Massal
Kecepatan situs sangat dipengaruhi aset media, dan di sinilah crawler menunjukkan gigi lainnya. Tab Images mendaftar semua gambar yang ditemukan beserta ukuran file, dimensi, dan atribut alt-nya.
Filter gambar berukuran lebih dari 100 KB untuk menemukan kandidat kompresi. Pada satu klien e-commerce, langkah sederhana ini berhasil memangkas waktu muat halaman kategori dari 4,2 detik menjadi 2,1 detik.
Anda juga bisa mengecek gambar yang alt text-nya kosong. Ini bukan cuma soal aksesibilitas, tapi juga peluang kehilangan sinyal relevansi untuk image search.
Lebih jauh, fitur custom extraction bisa dipakai untuk mengambil atribut srcset, lazy loading, atau informasi format WebP—berguna kalau Anda sedang mendorong migrasi format gambar di tim frontend.
Integrasi dengan Google Analytics dan Search Console
Ini fitur yang membuat Screaming Frog website crawler terasa seperti pusat komando audit. Dengan menyambungkan akun Google, data crawl bisa diperkaya dengan metrik perilaku dan performa pencarian.
Buka menu Configuration API Access Google Search Console. Setelah otorisasi, kolom tambahan akan muncul: impresi, klik, CTR, dan posisi rata-rata per URL.
Dari sini Anda bisa langsung memfilter halaman dengan posisi bagus tapi CTR rendah, lalu memutuskan untuk menulis ulang judul dan meta description-nya. Ini contoh nyata bagaimana data teknis dan data performa bertemu dalam satu meja kerja.
Menghubungkan PageSpeed Insights untuk Data Core Web Vitals
Integrasi lain yang sayang dilewatkan adalah PageSpeed Insights. Dengan API key yang didaftarkan, crawler bisa menarik data lapangan Core Web Vitals untuk setiap URL.
Hasilnya, Anda melihat halaman mana yang punya LCP buruk, CLS tinggi, atau INP yang bermasalah. Data ini bisa diekspor langsung ke CSV untuk diserahkan ke tim developer sebagai tiket perbaikan.
Praktisnya, alih-alih membuka satu per satu URL di PageSpeed Insights, Anda menguji ratusan halaman sekaligus dalam satu sesi crawl. Efisiensi waktunya luar biasa.
Custom Extraction: ketika Fitur Bawaan Tidak Cukup
Setiap situs punya elemen unik: harga produk, rating bintang, stok barang, atau nama penulis. Fitur custom extraction memungkinkan Anda menambahkan kolom data sesuai kebutuhan.
Caranya, buka Configuration Custom Extraction. Anda bisa memilih mode CSS Path, XPath, atau Regex. Setelah itu, masukkan selector untuk elemen yang ingin diambil, beri nama kolom, dan crawl ulang.
Sebagai ilustrasi, saya pernah memakai fitur ini untuk mengekstrak harga produk dan status stok dari 8.000 halaman katalog. Hasilnya dipakai tim pricing untuk memantau perubahan kompetitor secara berkala.
Kemampuan screaming frog website crawler juga berguna untuk memverifikasi implementasi schema markup. Anda bisa mengekstrak isi atribut JSON-LD lalu membandingkannya dengan pedoman struktur data Google.
Panduan screaming frog website crawler tidak akan lengkap tanpa menyebut fitur ini, karena custom extraction adalah jembatan antara crawl generik dan kebutuhan bisnis yang spesifik.
Teknik Crawl Lanjutan untuk Situs Besar
Ketika situs Anda mencapai ratusan ribu URL, pendekatan crawl standar akan memakan waktu lama dan memori besar. Ada beberapa strategi yang bisa diterapkan.
Segmentasi Crawl per Direktori
Daripada meng-crawl seluruh situs dalam satu sesi, pecah pekerjaan berdasarkan direktori atau subdomain. Crawl bagian /blog/ dulu, lalu /produk/, lalu /kategori/.
Cara screaming frog website crawler membuat setiap sesi lebih ringan dan hasilnya lebih mudah dianalisis. Selain itu, jika terjadi error di tengah crawl, Anda tidak kehilangan seluruh progress.
Kekurangannya, Anda perlu menggabungkan hasil beberapa crawl untuk melihat gambaran utuh. Untungnya, fitur ekspor CSV membuat penggabungan data ini cukup dilakukan di spreadsheet.
Memanfaatkan Mode List untuk URL Prioritas
Jika prioritas Anda hanya memeriksa halaman yang mendatangkan trafik, gunakan mode List. Ekspor URL dengan klik tertinggi dari Search Console, tempel ke dalam list, lalu jalankan crawl.
Hasilnya, audit fokus pada halaman yang benar-benar penting bagi bisnis, bukan pada halaman arsip lama yang sudah tidak relevan lagi.
Kesalahan Umum yang Sering Terjadi saat Menggunakan Screaming Frog Website Crawler
Berdasarkan pengalaman mendampingi tim internal berbagai perusahaan, ada beberapa jebakan yang berulang. Mengetahuinya lebih awal bisa menghemat banyak waktu.
- Crawl tanpa batas yang jelas. Akibatnya sesi berjalan berjam-jam dan data yang dihasilkan terlalu besar untuk dianalisis. Tetapkan limit sesuai tujuan audit.
- Mengabaikan robots.txt. Alat ini menghormati aturan robots.txt secara default, sehingga halaman yang diblokir tidak akan muncul. Jika ingin memaksa, nonaktifkan opsi tersebut—tapi pahami risikonya.
- Membandingkan data crawl dengan data Search Console tanpa normalisasi. URL dengan parameter atau huruf besar-kecil bisa dianggap berbeda oleh kedua sistem, menghasilkan perbandingan yang menyesatkan.
- Langsung meminta developer memperbaiki semua temuan. Prioritaskan berdasarkan dampak trafik dan usaha perbaikan, bukan berdasarkan urutan alfabet dalam laporan.
- Lupa menyimpan konfigurasi. Fitur save config sangat membantu agar crawl berikutnya tidak perlu mengatur ulang dari awal.
Kesalahan kelima sering dianggap sepele, padahal dampaknya besar ketika audit dilakukan berulang tiap kuartal. Simpan konfigurasi dalam file terpisah agar bisa dipakai ulang.
Mengubah Temuan Crawl Menjadi Rencana Kerja Nyata
Laporan crawl yang tebal tidak ada gunanya kalau tidak diterjemahkan menjadi tindakan. Setelah data terkumpul, langkah selanjutnya adalah memilah dan memprioritaskan.
Cara yang saya pakai: kelompokkan temuan ke dalam tiga keranjang. Keranjang pertama berisi masalah yang memblokir indeks atau akses, seperti 5xx error dan halaman penting yang ter-noindex.
Keranjang kedua berisi masalah yang memengaruhi kualitas, seperti judul duplikat, konten tipis, dan gambar tanpa alt. Keranjang ketiga berisi peluang optimasi, seperti halaman dengan CTR rendah atau konten yang berpotensi diperkaya.
Menyusun Tiket Perbaikan yang Ramah Developer
Developer biasanya tidak butuh laporan bertab-tab; mereka butuh daftar yang jelas. Sertakan URL spesifik, contoh masalah, dan ekspektasi hasil perbaikan dalam setiap tiket.
Sebagai contoh, alih-alih menulis “banyak broken link internal”, tulis: “27 tautan internal menuju URL 404, daftar terlampir, perbaiki dengan redirect 301 ke halaman pengganti yang relevan”.
Semakin spesifik instruksinya, semakin cepat pekerjaan selesai dan semakin kecil kemungkinan salah tafsir antar tim.
Alternatif dan Pelengkap Screaming Frog Website Crawler
Meski sangat mumpuni, tidak semua kebutuhan bisa ditangani alat ini sendirian. Kadang kita screaming frog website crawler perlu alat pendamping untuk kasus tertentu.
Untuk analisis log file, ada tools khusus yang membaca log server dan memberi gambaran cara bot Google merayapi situs Anda. Data ini tidak bisa digantikan oleh crawler karena crawler hanya meniru, bukan merekam kunjungan bot sungguhan.
Untuk memantau perubahan teknis secara berkala, beberapa tim memakai alat cloud yang menjalankan crawl terjadwal. Sementara Screaming Frog website crawler terbaru tetap menjadi pilihan utama untuk audit mendalam yang dilakukan manual.
Kapan Menggunakan Alat Cloud dan Kapan Desktop
Aturan praktisnya begini: gunakan versi desktop untuk audit menyeluruh yang membutuhkan konfigurasi rumit dan integrasi data. Gunakan alat cloud untuk pemantauan rutin harian yang tidak butuh intervensi manual.
Kombinasi keduanya memberi keseimbangan antara kedalaman analisis dan efisiensi operasional. Banyak tim SEO akhirnya memakai keduanya secara berdampingan, bukan saling menggantikan.
Tips Profesional Mengoptimalkan Penggunaan
Ada beberapa kebiasaan kecil yang membedakan pengguna pemula dengan praktisi berpengalaman. Semuanya sederhana, tapi dampaknya besar.
Pertama, selalu simpan file crawl (format.seospider) sebelum menutup aplikasi. File ini bisa dibuka kembali tanpa harus crawl ulang, sangat berguna saat presentasi atau rapat review.
Kedua, manfaatkan fitur compare untuk membandingkan dua crawl dari waktu berbeda. Dari situ Anda bisa melihat perbaikan mana yang berhasil dan masalah baru apa yang muncul.
Ketiga, gunakan filter dan segmentasi sebelum mengekspor. Mengekspor seluruh data lalu memilah di spreadsheet hanya membuang waktu; lebih efisien memfilter dulu di aplikasi.
Terakhir, jangan lupa memeriksa tab Sitemaps. Apa pun hasilnya, pastikan jumlah URL di sitemap selaras dengan jumlah halaman yang benar-benar bisa diakses oleh crawler.
Pertanyaan yang Sering Diajukan Seputar Screaming Frog Website Crawler
Bagian ini merangkum pertanyaan yang paling sering muncul, baik dari pemula maupun praktisi yang sudah lama berkecimpung di dunia SEO teknis.
Apakah Screaming Frog Website Crawler Gratis?
Versi gratis tersedia dengan batas 500 URL per sesi dan beberapa fitur terbatas, seperti integrasi API dan custom extraction. Untuk pekerjaan profesional yang menangani situs besar, versi berbayar menjadi kebutuhan.
Untungnya, biaya lisensi dibayarkan tahunan dan harganya kompetitif langsung dari produsen, jadi tidak ada biaya tersembunyi dari perantara.
Apakah Bisa Dijalankan di Server tanpa Antarmuka Grafis?
Bisa, melalui command line interface yang tersedia dalam paket instalasi. Mode ini ideal untuk menjalankan crawl terjadwal di server atau mesin virtual.
Banyak tim DevOps memanfaatkan mode CLI ini untuk menghasilkan laporan crawl otomatis yang dikirim ke dashboard internal setiap minggu.
Berapa Jumlah URL Maksimal yang Bisa Di-crawl?
Secara teknis, alat ini bisa menangani jutaan URL, tapi batasnya bergantung pada RAM dan penyimpanan komputer. Untuk crawl di atas harga kompetitif langsung dari produsen URL, disarankan memakai mesin dengan memori besar dan hard disk yang cukup.
Kalau ragu, mulailah dari crawl tersegmentasi per direktori seperti yang dijelaskan sebelumnya. Cara ini lebih aman dan hasilnya lebih mudah dikelola.
Apakah Data Crawl Bisa Dipakai untuk Audit Kompetitor?
Tentu saja. Cukup masukkan URL kompetitor sebagai seed. Anda bisa melihat struktur navigasi mereka, jumlah halaman yang terindeks, hingga strategi internal linking yang mereka pakai.
Tapi ingat, crawl kompetitor hanya menampilkan apa yang bisa diakses publik. Data analitik seperti trafik dan konversi tetap tidak akan terlihat.
Bagaimana Cara Memastikan Hasil Crawl Sesuai Kondisi Terbaru?
Gunakan fitur compare antara crawl lama dan baru, lalu periksa selisih pada kolom status code dan jumlah tautan. Selain itu, selalu kosongkan cache crawl sebelum memulai sesi baru agar data tidak tercampur dengan hasil lama.
Kalau situs punya cache CDN agresif, tambahkan parameter unik pada URL seed agar crawler mengambil versi terbaru dari server asal.
Merawat Kebiasaan Audit yang Berkelanjutan
Audit teknis screaming frog website crawler bukan proyek sekali jadi. Situs terus berubah, konten bertambah, dan plugin diperbarui—semua itu bisa memunculkan masalah baru kapan saja.
Karena screaming frog website crawler jadwalkan crawl rutin, misalnya setiap awal bulan, dengan konfigurasi yang sudah disimpan. Bandingkan hasilnya dengan crawl sebelumnya untuk melihat tren perbaikan.
Libatkan tim konten, developer, dan SEO dalam satu forum review bulanan. Dengan begitu, temuan dari crawler tidak berhenti di folder laporan, tetapi benar-benar berubah menjadi perbaikan nyata di situs.
Screaming Frog website crawler adalah alat yang kuat, tetapi kekuatannya baru terasa saat dipadukan dengan proses kerja yang disiplin. Panduan screaming frog website crawler lengkap ini mengajak Anda bukan sekadar menguasai tombol demi tombol, melainkan membangun kebiasaan audit yang konsisten.
Mulailah dari crawl kecil hari ini, baca satu tab laporan, dan perbaiki satu masalah. Lama-kelamaan, seluruh situs akan terasa jauh lebih rapi—dan performa organiknya mengikuti.