Noindex Meta Tag: Panduan Lengkap dan 5 Tips Praktis
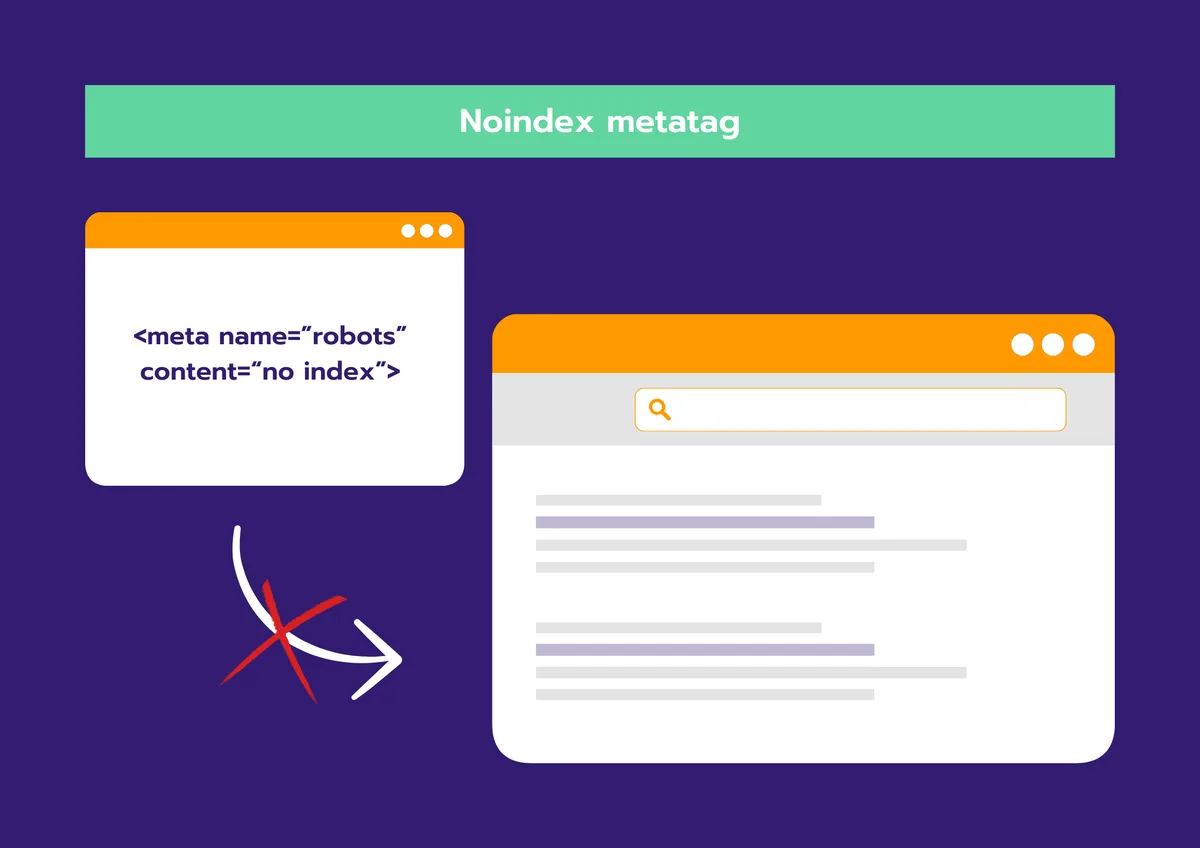
Noindex meta tag adalah instruksi teknis yang memberi tahu mesin pencari agar tidak menampilkan halaman tertentu di hasil pencarian. Kalau Anda pernah penasaran kenapa sebuah URL muncul di Google meski sudah dihapus dari menu situs, besar kemungkinan halaman itu belum diberi noindex meta tag dengan benar.
Artikel ini adalah panduan noindex meta tag lengkap yang membedah cara kerja tag tersebut, kapan harus dipakai, dan bagaimana menerapkannya tanpa merusak visibilitas situs. Sebagai bagian dari klaster topik teknis SEO on-page, pembahasan ini juga menyinggung robots.txt, sitemap XML, dan kontrol indeks di Google Search Console sebagai sub-topik lanjutan yang saling terkait.
Sepanjang pembahasan, saya noindex meta tag akan menurunkan lima tips praktis yang bisa langsung Anda eksekusi. Sebagian besar tips lahir dari kesalahan yang saya temui saat mengaudit situs klien, bukan dari teori buku manual. Jadi, mari mulai dari dasar.
Apa Itu Noindex Meta Tag dan Bagaimana Cara Kerjanya
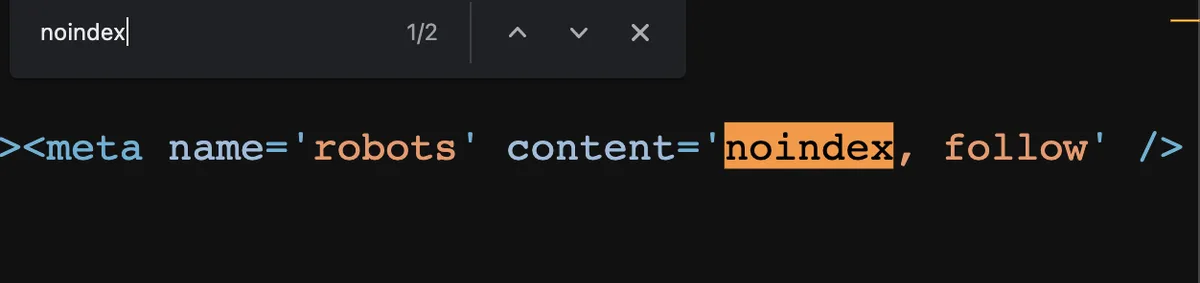
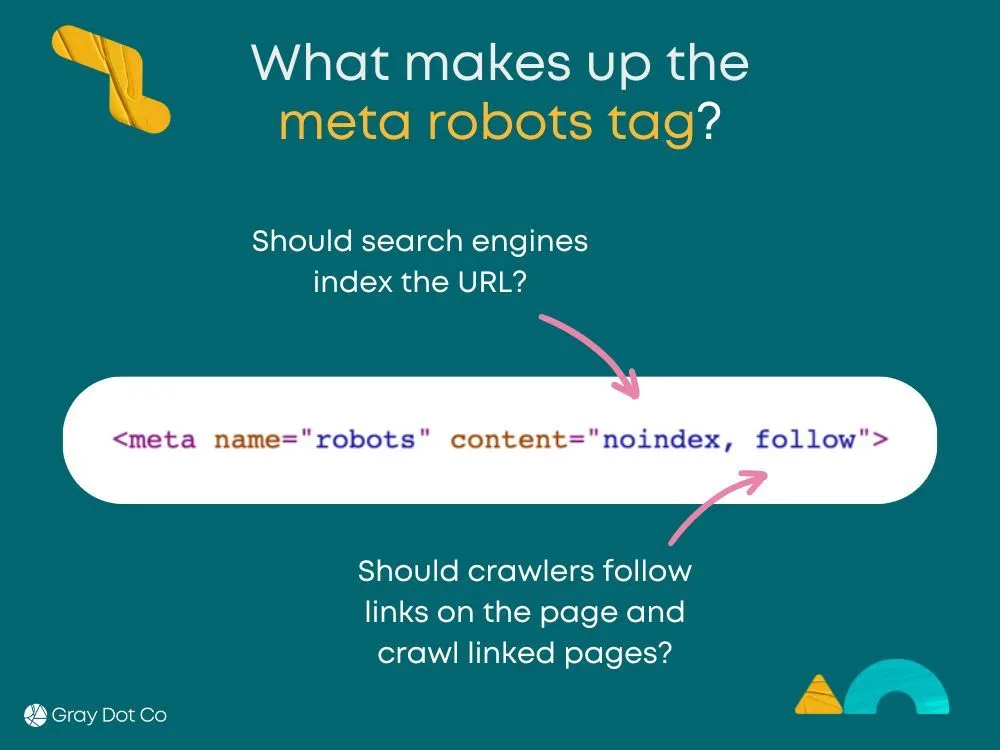
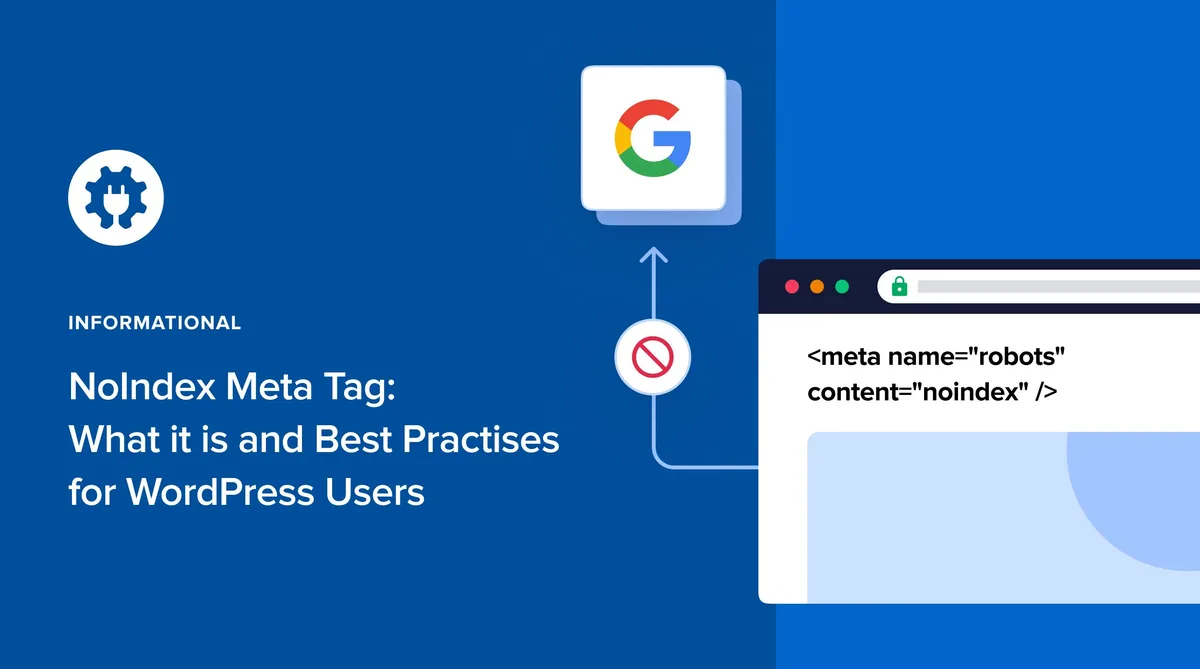
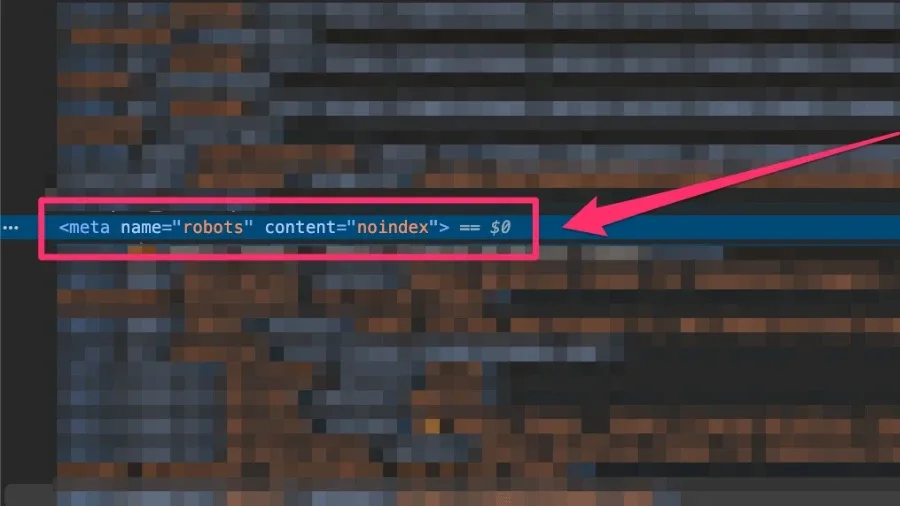
Secara sederhana, noindex meta tag adalah potongan kode HTML yang diletakkan di bagian <head> halaman. Tag ini berbunyi <meta name="robots" content="noindex"> dan berfungsi sebagai permintaan sopan kepada crawler agar halaman tidak dimasukkan ke indeks pencarian.
Perlu digarisbawahi: “tidak diindeks” bukan berarti “tidak di-crawl”. Bot tetap bisa mengunjungi halaman, membaca isinya, mengikuti tautan di dalamnya, tetapi tidak menyimpannya ke dalam basis data hasil pencarian. Perbedaan halus ini sering disalahpahami, dan akibatnya banyak praktisi mengira halaman sudah aman padahal masih bisa muncul di SERP.
Ada beberapa varian penulisan yang sah. Anda bisa memakai noindex tunggal, kombinasi noindex, nofollow, atau versi khusus bot seperti <meta name="googlebot" content="noindex">. Untuk kebutuhan umum, cukup satu direktif noindex di tag robots global.
Perbedaan Noindex, Nofollow, dan Disallow
Tiga istilah ini kerap tertukar. Noindex mengatur apakah halaman boleh masuk indeks. Nofollow mengatur apakah tautan di halaman boleh diikuti dan diteruskan otoritasnya. Disallow — yang ditulis di robots.txt — mengatur apakah crawler boleh mengakses URL sama sekali.
Kesalahan klasik yang saya temui di lapangan: seseorang memblokir halaman lewat robots.txt sambil berharap halaman itu hilang dari indeks. Hasilnya justru sebaliknya. Bot tidak bisa masuk untuk membaca noindex meta tag, sehingga halaman lama tetap bertahan di indeks meski sudah “diblokir”. Ini kombinasi yang berbahaya jika tidak dipahami urutannya.
Aturan praktisnya begini: jika tujuan Anda menghapus halaman dari indeks, izinkan crawler mengaksesnya, pasang noindex meta tag, lalu tunggu Google membaca ulang. Setelah halaman hilang dari indeks, baru boleh diblokir di robots.txt bila memang ingin menghemat crawl budget.
Kapan Noindex Meta Tag Wajib Dipakai
Noindex meta tag bukan alat serba bisa. Memasangnya sembarangan bisa memangkas trafik organik yang seharusnya Anda dapat. Berikut situasi di mana tag ini benar-benar tepat sasaran.
Pertama, halaman hasil pencarian internal situs. URL seperti /search?q=... bisa menghasilkan ribuan variasi yang tidak bernilai di indeks. Kedua, halaman arsip bertanggal yang isinya duplikat dari halaman kategori. Ketiga, halaman uji coba atau staging yang tidak sengaja terbuka ke publik.
Keempat, halaman transaksional sensitif seperti keranjang belanja, halaman checkout, dan halaman terima kasih setelah pendaftaran. Kelima, halaman tipis (thin content) yang isinya hanya beberapa baris tanpa nilai tambah. Untuk kategori terakhir, pertimbangkan apakah lebih baik memperbaiki kontennya daripada menyembunyikannya.
Halaman yang Sebaiknya Tidak Diberi Noindex
Jangan pernah memasang noindex meta tag pada halaman produk utama, artikel pilar, halaman kategori yang menargetkan kata kunci komersial, atau halaman layanan. Ini adalah halaman yang justru harus bersaing di hasil pencarian.
Saya pernah melihat kasus sebuah toko online yang tanpa sengaja menaruh noindex di seluruh halaman produk karena salah konfigurasi template. Butuh tiga minggu bagi mereka menyadari trafiknya anjlok drastis. Pelajarannya: selalu audit setelah melakukan perubahan massal pada template.
Halaman tag dan kategori dengan konten tipis juga perlu kehati-hatian. Sebelum memutuskan noindex, cek dulu apakah halaman tersebut punya potensi trafik long-tail. Kadang yang dibutuhkan bukan noindex, melainkan penambahan deskripsi kategori yang informatif.
Panduan Noindex Meta Tag Lengkap: Cara Penerapan di Berbagai Platform
Panduan noindex meta tag lengkap harus mencakup penerapan teknis di platform yang paling banyak dipakai. Cara memasangnya berbeda-beda tergantung CMS, dan kesalahan kecil di satu tempat bisa membuat tag tidak terbaca.
Di HTML murni, tag diletakkan di dalam <head>, sebaiknya setelah tag charset dan sebelum tag canonical. Urutan ini bukan aturan mutlak, tetapi membantu keterbacaan saat audit. Pastikan tidak ada tag robots lain yang bertentangan di halaman yang sama.
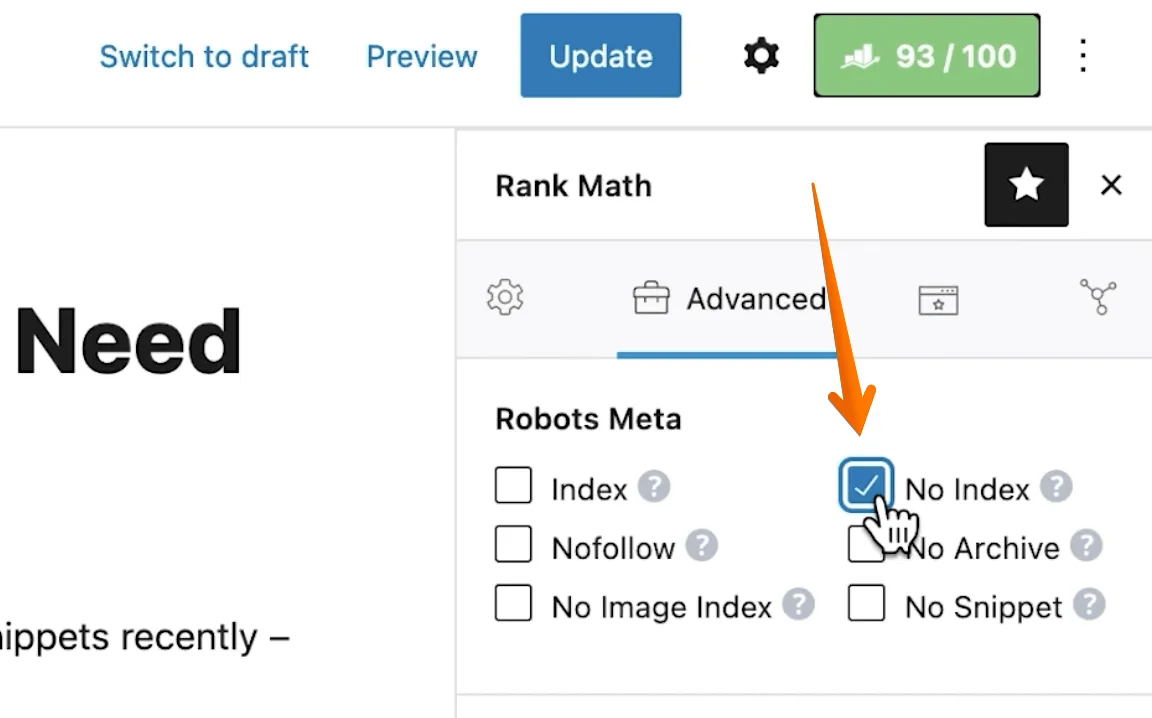
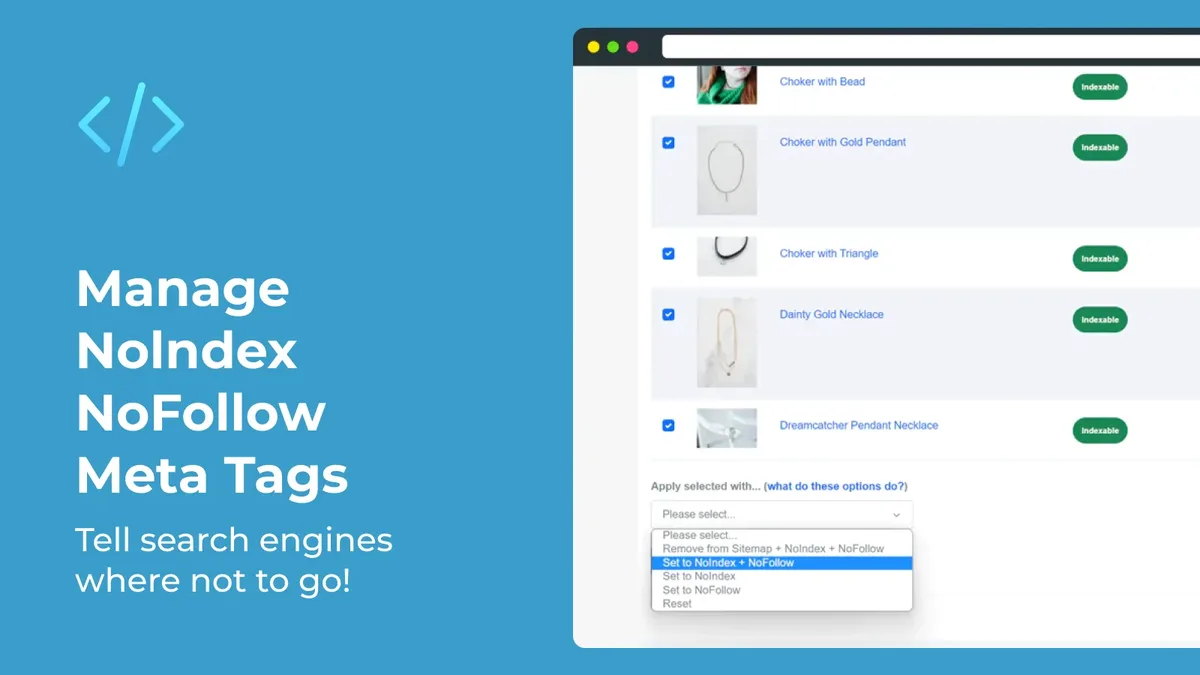
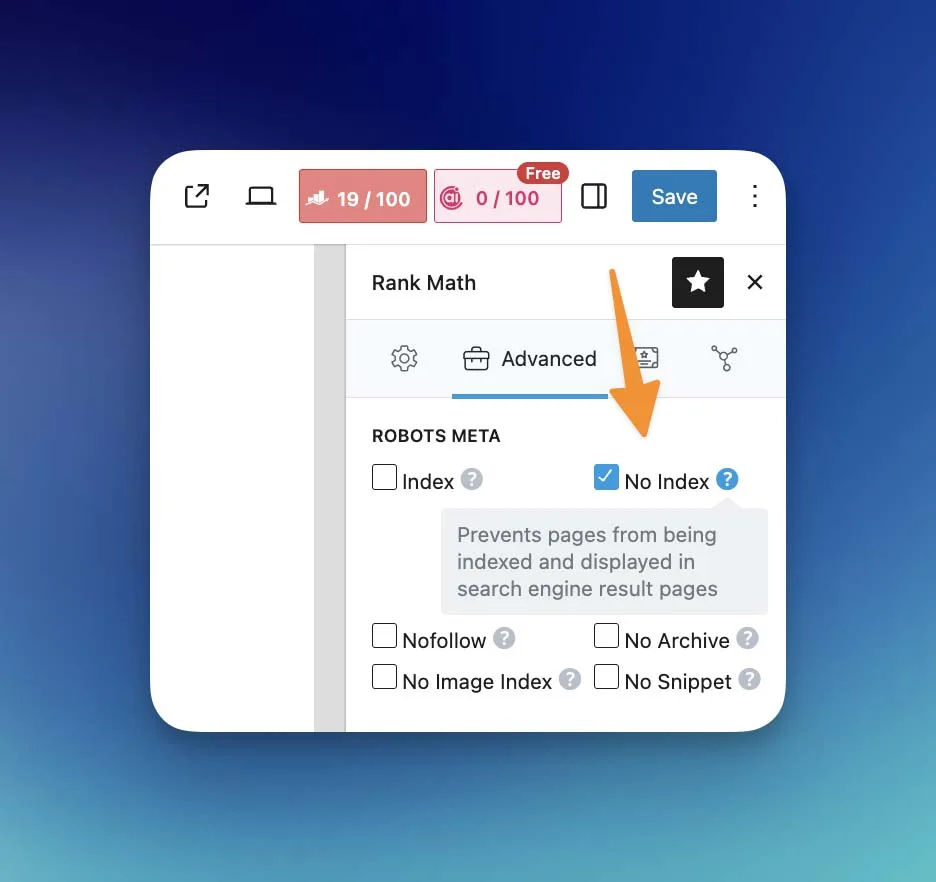
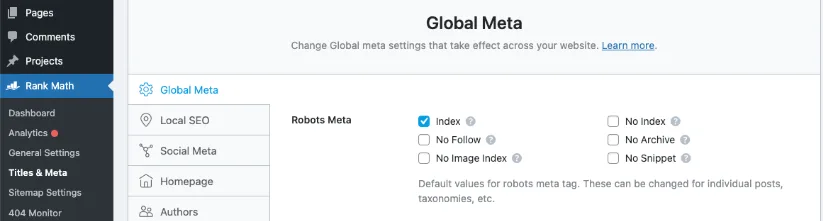
Di WordPress, Anda bisa memakai plugin SEO seperti Yoast atau Rank Math untuk mengatur noindex per halaman lewat panel Advanced. Untuk penerapan massal berdasarkan tipe konten, gunakan filter wp_robots di functions.php. Hati-hati: plugin SEO modern sudah menginjeksi tag robots sendiri, jadi menambahkan tag manual bisa menghasilkan duplikasi.
Penerapan di Next.js, Nuxt, dan Framework Modern
Di Next.js, gunakan Metadata API dengan mengekspor objek robots: { index: false, follow: true } pada file layout atau page. Framework akan merender tag yang tepat di server. Untuk halaman dinamis, pastikan logika noindex dijalankan di sisi server, bukan hanya di client, agar crawler melihatnya.
Di Nuxt, atur melalui useHead atau useSeoMeta dengan properti robots. Di Astro, cukup tambahkan tag di komponen head layout. Prinsipnya sama: tag harus ada di HTML awal yang diterima crawler, bukan disuntikkan lewat JavaScript setelah halaman dimuat.
Ini poin yang sering terlewat. Google memang bisa merender JavaScript, tetapi prosesnya lebih lambat dan tidak selalu sempurna. Jika noindex meta tag hanya muncul setelah hidrasi React, ada risiko bot melihat versi HTML awal tanpa tag tersebut.
5 Tips Praktis Menerapkan Noindex Meta Tag dengan Aman
Inilah inti dari judul di atas. Lima tips berikut saya susun berdasarkan pola kesalahan yang paling sering muncul saat audit teknis. Setiap tips punya konteks, contoh, dan langkah eksekusi yang bisa Anda tiru.
Tips 1: Verifikasi dengan Inspeksi URL sebelum dan sesudah Perubahan
Jangan pernah menganggap tag sudah bekerja hanya karena kode sudah ditulis. Gunakan fitur Inspeksi URL di Google Search Console untuk melihat HTML yang benar-benar diterima Google. Bagian “HTML yang dirender” akan menunjukkan apakah noindex meta tag terbaca atau tidak.
Setelah verifikasi, minta pengindeksan ulang lewat tombol yang sama. Proses ini mempercepat Google membaca versi terbaru. Tanpa langkah ini, Anda bisa menunggu berminggu-minggu untuk perubahan yang seharusnya selesai dalam hitungan hari.
Contoh nyata: sebuah klien memasang hal ini pada 200 halaman arsip, tetapi 30 halaman tetap muncul di SERP setelah sebulan. Ternyata tag dipasang lewat JavaScript yang gagal dieksekusi bot. Inspeksi URL akan langsung menunjukkan masalah seperti ini.
Tips 2: Jangan Gabungkan Noindex dengan Disallow di Robots.txt
Ini tips paling penting dan paling sering dilanggar. Ketika langkah ini dipasang bersamaan dengan disallow, bot tidak bisa membaca tag tersebut. Halaman pun tetap bertahan di indeks, kadang dengan snippet yang sudah usang.
Urutan yang benar: pasang noindex meta tag, biarkan halaman tetap bisa diakses, tunggu sampai hilang dari indeks, baru tambahkan disallow bila perlu. Saya biasanya memberi jeda minimal dua sampai empat minggu sambil memantau laporan Cakupan di Search Console.
Untuk halaman yang sangat sensitif dan harus hilang secepat mungkin, gunakan alat Penghapusan di Search Console sebagai langkah sementara. Ini bukan solusi permanen, tetapi memberi waktu bagi langkah ini untuk diproses.
Tips 3: Gunakan Header X-Robots-Tag untuk File Non-HTML
Hal ini hanya bekerja pada halaman HTML. Untuk PDF, gambar, atau file dokumen lain, Anda harus memakai header HTTP X-Robots-Tag: noindex. Header ini dikirim oleh server dan dibaca bot dengan cara yang sama.
Kasus umum: perusahaan mengunggah katalog PDF berisi harga internal ke folder publik. Karena tidak ada header X-Robots-Tag, file tersebut terindeks dan muncul di pencarian. Memasang noindex lewat header adalah cara paling bersih untuk mencegahnya.
Di server Nginx, tambahkan direktif header pada lokasi file. Di Apache, gunakan Header set X-Robots-Tag "noindex" dalam konfigurasi direktori. Untuk CDN seperti Cloudflare, atur lewat Rules agar header disisipkan otomatis.
Tips 4: Audit Massal dengan Crawler untuk Menemukan Konflik Tag
Pada situs besar, konflik tag robots hampir tidak terhindarkan. Satu halaman bisa punya tag noindex dari plugin, sekaligus tag index dari template. Ketika dua direktif bertentangan, Google biasanya memilih yang paling restriktif, tetapi hasilnya bisa tidak konsisten.
Gunakan crawler seperti Screaming Frog atau Sitebulb untuk memindai seluruh situs. Filter halaman yang punya lebih dari satu tag robots, lalu periksa mana yang menang. Ini pekerjaan membosankan, tetapi menyelamatkan Anda dari kehilangan trafik diam-diam.
Buat aturan internal: hanya satu sumber kebenaran untuk kontrol indeks. Kalau plugin SEO sudah menangani, jangan tambahkan tag manual di template. Dokumentasikan keputusan ini agar tim konten dan developer tidak saling bertabrakan.
Tips 5: Pantau Dampak Noindex Meta Tag di Search Console Secara Berkala
Setiap penerapan noindex meta tag punya konsekuensi. Pantau laporan Halaman di Search Console untuk melihat status “Dikecualikan oleh tag noindex”. Angka yang naik wajar jika Anda memang menambahkan halaman baru ke daftar noindex.
Yang perlu diwaspadai adalah kenaikan tak terduga pada halaman yang seharusnya diindeks. Lonjakan mendadak di kategori “noindex” bisa menjadi sinyal bahwa template rusak atau plugin salah konfigurasi. Respons cepat menyelamatkan trafik.
Buat jadwal audit bulanan sederhana: bandingkan jumlah halaman terindeks dengan bulan sebelumnya, cek anomali, dan telusuri penyebabnya. Kedisiplinan kecil ini jauh lebih efektif daripada perbaikan darurat setelah trafik anjlok.
Noindex Meta Tag Terbaru: Perubahan Perilaku Mesin Pencari yang Perlu Dipahami
Langkah ini terbaru tidak berubah secara sintaks, tetapi cara mesin pencari memprosesnya terus berevolusi. Google kini lebih cepat membaca perubahan tag, terutama jika halaman sering di-crawl. Namun, kecepatan ini tetap bergantung pada otoritas dan frekuensi crawl situs Anda.
Satu perubahan yang penting: Google secara bertahap mengurangi dukungan untuk direktif noindex yang disampaikan lewat JavaScript yang dijalankan di client. Tag harus ada di HTML awal atau di header HTTP. Ini menegaskan pentingnya rendering server untuk situs modern.
Bing juga mengikuti pola serupa, meski dengan latensi berbeda. Jika trafik Anda bergantung pada Bing, jangan mengandalkan asumsi bahwa perilakunya identik dengan Google. Verifikasi lewat alat Webmaster Bing secara terpisah.
Interaksi Noindex dengan Canonical dan Hreflang
Kombinasi noindex dan canonical sering menimbulkan kebingungan. Jika halaman A punya canonical ke B sekaligus noindex, sinyalnya bertentangan. Google cenderung mengabaikan canonical ketika noindex hadir, sehingga halaman A tidak diindeks dan tidak meneruskan sinyal ke B.
Untuk halaman duplikat yang ingin dikonsolidasikan, pilih salah satu strategi. Gunakan canonical jika ingin halaman tetap bisa diakses dan sinyalnya diteruskan. Gunakan noindex jika halaman memang tidak perlu ada di indeks sama sekali.
Pada implementasi hreflang multibahasa, hindari menambahkan noindex pada halaman versi bahasa tertentu kecuali benar-benar tidak relevan. Noindex pada satu versi bisa memutus rantai hreflang dan membingungkan mesin pencari soal versi mana yang harus ditampilkan.
Tabel Perbandingan: Noindex Meta Tag vs Metode Kontrol Indeks Lain
Memilih metode kontrol indeks yang tepat menentukan hasil akhir. Tabel berikut membandingkan empat pendekatan utama berdasarkan cara kerja, kecepatan, dan risiko yang menyertainya.
| Metode | Cara Kerja | Cocok Untuk | Risiko Utama |
|---|---|---|---|
| Noindex meta tag | Direktif di HTML head, dibaca saat crawl | Halaman HTML yang tetap perlu diakses bot | Tidak terbaca jika halaman diblokir robots.txt |
| X-Robots-Tag | Header HTTP dari server | PDF, gambar, file non-HTML | Salah konfigurasi server bisa mengenai seluruh situs |
| Robots.txt disallow | Memblokir akses crawler ke URL | Menghemat crawl budget, folder internal | Tidak menghapus halaman dari indeks |
| Alat penghapusan Search Console | Permintaan manual sementara | Halaman mendesak yang harus hilang cepat | Bersifat sementara, tidak permanen |
Dari tabel di atas, terlihat bahwa hal ini adalah pilihan utama untuk halaman HTML yang masih ingin dirayapi. Kombinasikan dengan alat penghapusan hanya untuk situasi darurat, bukan sebagai rutinitas.
Kesalahan Umum yang Merusak Efektivitas Noindex Meta Tag
Banyak penerapan langkah ini gagal bukan karena sintaksnya salah, melainkan karena konteksnya keliru. Berikut pola yang paling sering saya temui saat menangani masalah indeks.
Kesalahan pertama: menaruh tag di <body> alih-alih <head>. Tag di body diabaikan oleh sebagian besar crawler. Kesalahan kedua: menulis atribut dengan ejaan salah, misalnya content="no-index" dengan tanda hubung. Direktif yang tidak dikenali akan diabaikan tanpa peringatan.
Kesalahan ketiga: mengandalkan plugin yang ternyata tidak mengeluarkan tag pada halaman tertentu karena aturan prioritas. Kesalahan keempat: lupa menghapus noindex setelah situs staging dipromosikan ke produksi. Yang terakhir ini klasik dan mahal.
Kesalahan kelima: menerapkan noindex pada seluruh situs karena salah menempatkan tag di template header global. Ini pernah terjadi pada sebuah situs berita yang kehilangan hampir seluruh trafiknya dalam beberapa hari. Pemulihannya butuh waktu karena Google harus crawl ulang ribuan halaman.
Cara Cepat Mendeteksi Kesalahan Noindex
Mulai dari pencarian site: di Google untuk domain Anda. Jika halaman yang seharusnya muncul tidak ada, periksa tag robots-nya. Gunakan ekstensi browser atau view-source untuk melihat HTML mentah, bukan hasil render.
Selanjutnya, bandingkan dengan laporan Search Console. Halaman yang tiba-tiba masuk kategori “noindex” tanpa perubahan yang Anda sadari adalah sinyal kuat adanya kesalahan template. Segera periksa commit terakhir di repositori kode atau perubahan konfigurasi plugin.
FAQ Seputar Noindex Meta Tag
Bagian ini merangkum pertanyaan yang paling sering muncul saat tim konten dan developer berdiskusi soal kontrol indeks. Jawabannya dibuat ringkas agar mudah dijadikan rujukan cepat.
Apakah Noindex Meta Tag Langsung Menghapus Halaman dari Google?
Tidak langsung. Google perlu crawl ulang halaman untuk membaca tag, lalu memprosesnya. Proses ini bisa memakan waktu dari beberapa hari hingga beberapa minggu tergantung frekuensi crawl. Untuk hasil lebih cepat, minta pengindeksan ulang lewat Search Console.
Apakah Noindex Meta Tag Bisa Dipasang pada Halaman yang Sudah Terindeks?
Bisa, dan itulah cara standar menghapus halaman dari indeks. Pasang tag, pastikan halaman tetap dapat diakses bot, lalu tunggu Google membaca ulang. Setelah status di Search Console berubah menjadi dikecualikan, halaman akan hilang dari hasil pencarian.
Apa Bedanya Noindex dengan Nofollow?
Noindex mengatur indeks halaman, sedangkan nofollow mengatur apakah tautan di halaman diikuti. Keduanya bisa digabung, tetapi penggunaannya bergantung tujuan. Untuk menghapus halaman dari indeks, noindex adalah jawabannya, bukan nofollow.
Apakah Noindex Meta Tag Mempengaruhi Peringkat Halaman Lain?
Secara langsung tidak. Namun, jika halaman yang diberi noindex seharusnya meneruskan otoritas lewat tautan internal, efek tidak langsung bisa terasa. Pastikan halaman penting tetap dapat diakses dan diindeks agar aliran otoritas internal tidak terputus.
Bagaimana Cara Menghapus Noindex Meta Tag yang Sudah Terpasang?
Hapus tag dari HTML atau matikan opsi noindex di plugin SEO. Verifikasi dengan Inspeksi URL bahwa tag sudah tidak ada, lalu minta pengindeksan ulang. Pantau Search Console untuk memastikan halaman kembali masuk indeks dalam beberapa hari atau minggu berikutnya.
Langkah Lanjutan Setelah Menguasai Noindex Meta Tag
Setelah memahami panduan langkah ini lengkap di atas, langkah berikutnya adalah membangun kebiasaan audit. Kontrol indeks bukan pekerjaan sekali selesai. Seiring bertambahnya halaman, konflik tag dan kesalahan konfigurasi akan terus muncul.
Mulailah dari inventaris sederhana: daftar halaman yang sengaja diberi noindex, alasan, dan tanggal penerapan. Dokumen ini akan sangat berguna ketika tim berganti atau saat melakukan migrasi situs. Tanpa catatan, setiap audit dimulai dari nol.
Untuk pendalaman, pelajari topik turunan seperti manajemen crawl budget, konfigurasi sitemap XML, dan strategi konsolidasi halaman duplikat. Ketiganya saling melengkapi dengan noindex meta tag dalam menjaga kesehatan indeks situs secara keseluruhan. Sejujurnya, penguasaan detail kecil seperti ini yang membedakan situs yang tumbuh stabil dari situs yang trafiknya naik-turun tanpa pola jelas.
Untuk informasi rujukan lebih komprehensif, Anda juga dapat membaca referensi standar terpercaya seputar topik ini.
Simak juga kumpulan artikel dan tips lainnya di arsip artikel terkait kami.