Knowledge Graph Search API: Panduan Lengkap dan 5 Tips Mudah
Knowledge graph search API adalah antarmuka pemrograman yang memungkinkan aplikasi Anda menarik entitas dan relasi dari basis data graf pengetahuan secara terstruktur, bukan sekadar daftar tautan. Kalau Anda pernah mengetik nama tokoh di mesin pencari lalu melihat panel samping berisi profil, tanggal lahir, dan karya terkait, di situlah API semacam ini bekerja di balik layar.
Artikel ini adalah panduan knowledge graph search API lengkap yang membedah cara kerjanya, komponen utamanya, sampai lima tips praktis yang bisa langsung Anda terapkan. Saya akan membawa Anda dari konsep dasar hingga eksekusi teknis, termasuk jebakan yang sering membuat pemula tersandung.
Sebagai bagian dari klaster topik yang lebih besar seputar semantic web dan pencarian terstruktur, pembahasan knowledge graph search API juga menyinggung sub-topik turunan seperti skema data, query bahasa graf, dan integrasi ke mesin rekomendasi. Anggap saja ini peta jalan sebelum Anda menyelam ke dokumentasi resmi. Sebagai rujukan tambahan, Anda dapat membaca dokumentasi lengkap seputar knowledge graph search api di ensiklopedia resmi.
Apa Itu Knowledge Graph Search API dan Mengapa Penting
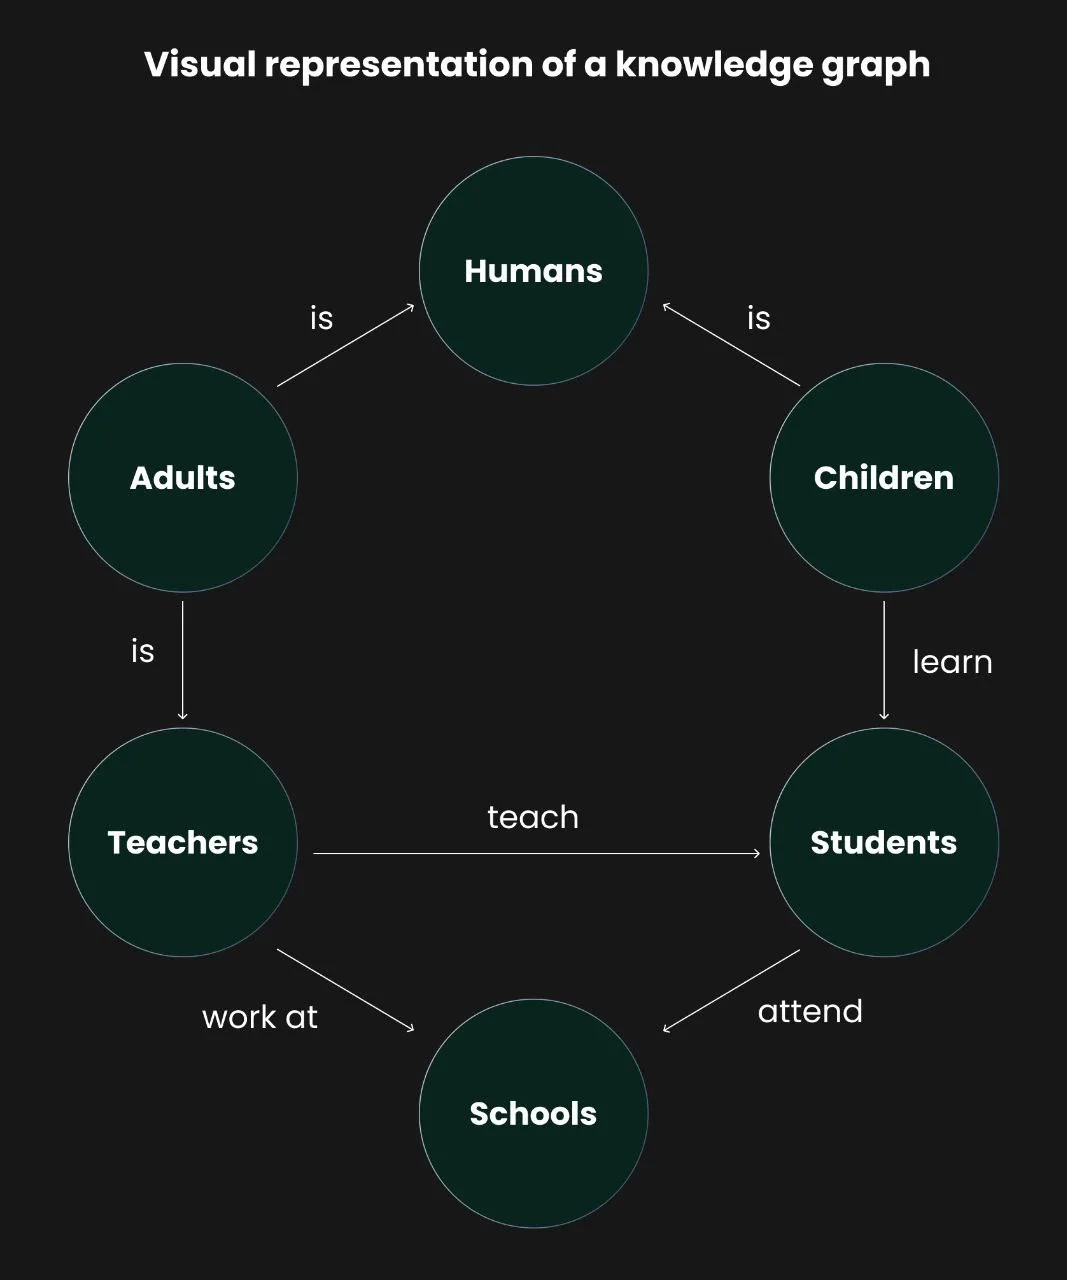
Secara sederhana, knowledge graph search api adalah layanan yang mengembalikan data dalam format graf—entitas sebagai simpul, relasi sebagai sisi—sehingga mesin bisa memahami konteks, bukan hanya kata kunci. Anda mengirim permintaan berdasarkan nama entitas atau ID, lalu menerima respons berisi atribut, tipe, dan koneksi ke entitas lain.
Bandingkan dengan pencarian teks biasa. Jika Anda mencari “Soekarno”, mesin konvensional mencocokkan string di halaman web. Sementara itu, API graf mengenali Soekarno sebagai entitas bertipe “Person”, dengan relasi “president of” ke Indonesia, “spouse” ke Fatmawati, dan “place of birth” ke Surabaya. Perbedaan ini terasa besar ketika Anda membangun fitur yang butuh akurasi faktual.
Menurut pengalaman saya mendampingi tim produk e-commerce, API ini sering jadi penyelamat saat mereka perlu menormalkan nama merek yang ditulis berantakan oleh pengguna. Alih-alih menebak lewat fuzzy matching, mereka mencocokkan langsung ke entitas graf yang sudah punya alias resmi.
Definisi Teknis dan Posisinya dalam Arsitektur Pencarian
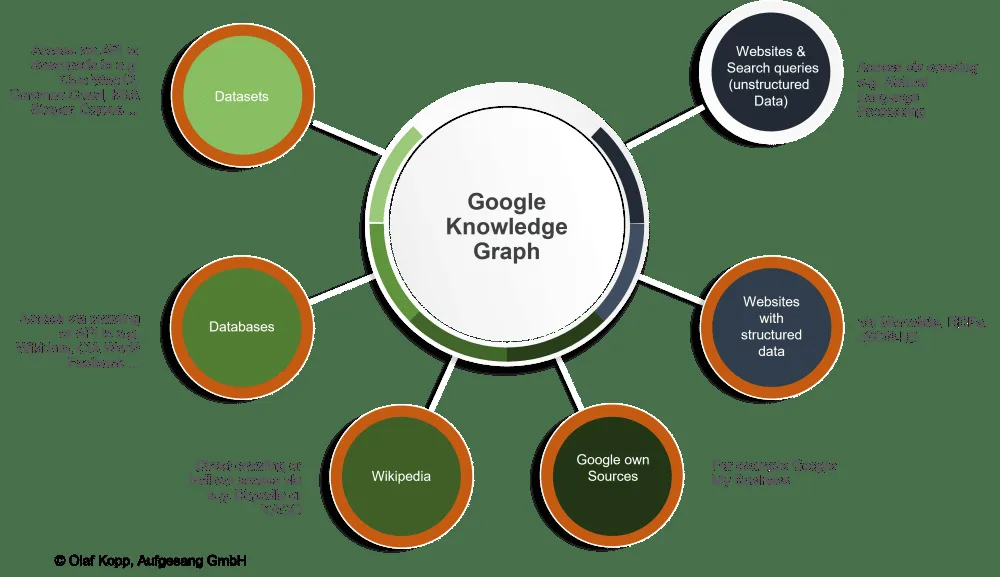
Dalam konteks teknis, layanan ini biasanya dibangun di atas model data RDF atau properti graf, lalu diekspos lewat endpoint HTTP bergaya REST atau GraphQL. Anda mengirim parameter seperti query, tipe entitas, dan bahasa, kemudian menerima JSON yang sudah terstruktur rapi.
Posisinya berada di lapisan antara basis data pengetahuan dan aplikasi pengguna. Di bawahnya ada penyimpanan graf (misalnya triple store), di atasnya ada antarmuka pencarian yang menampilkan hasil. Tanpa lapisan API ini, tim Anda harus menulis query graf manual setiap kali butuh data, yang jelas tidak efisien untuk produksi.
Cara Kerja Knowledge Graph Search API dari Request ke Response
Memahami alur kerja knowledge graph search API membantu Anda mendesain integrasi yang tahan banting. Prosesnya terbagi menjadi beberapa tahap yang bisa Anda optimalkan satu per satu.
Pertama, aplikasi mengirim request dengan parameter pencarian. Kedua, server API mencocokkan query ke indeks entitas, sering memakai pencarian berbasis embedding atau pencocokan prefix. Ketiga, server mengambil detail entitas beserta relasinya dari penyimpanan graf. Terakhir, respons dikembalikan dalam format terstruktur, biasanya JSON dengan skema yang konsisten.
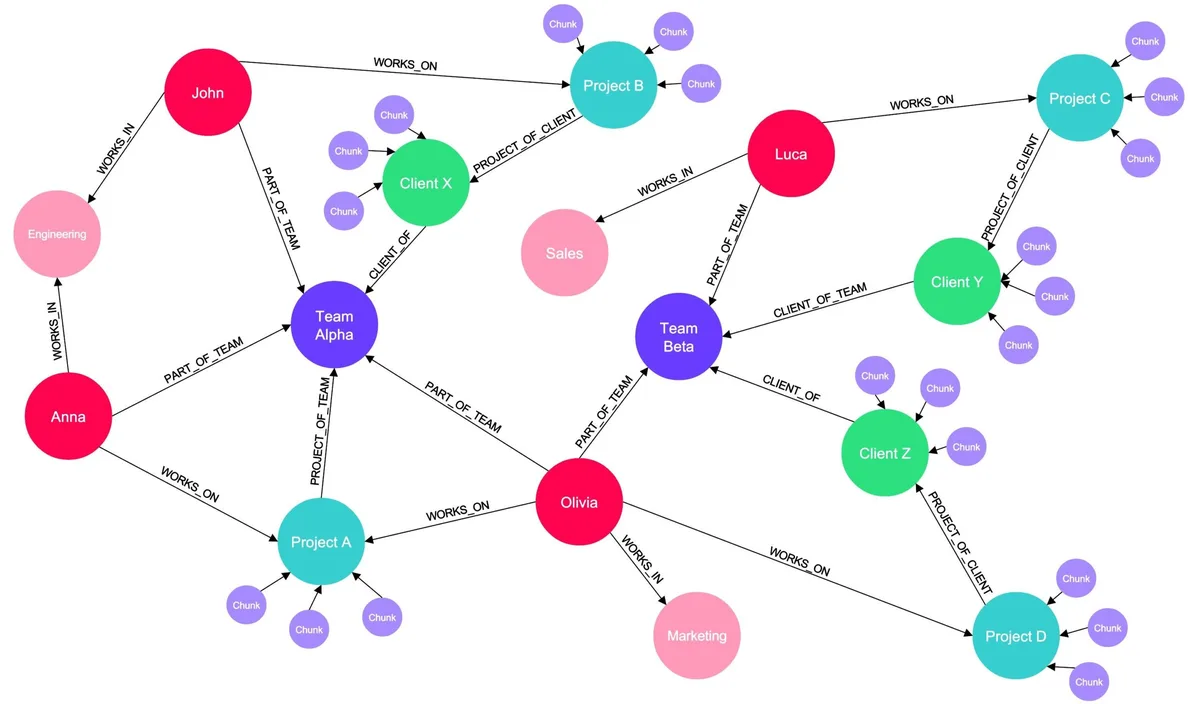
Anatomi Request yang Efisien
Request yang baik menyebutkan tipe entitas secara eksplisit. Jika Anda mencari “Apple”, tambahkan filter tipe “Organization” atau “Fruit” agar hasil tidak tercampur. Ini menghemat kuota dan mempercepat respons.
Manfaatkan juga parameter bahasa dan batas hasil. Menarik 500 hasil sekaligus hanya membebani jaringan tanpa dipakai; ambil 10-20 entitas teratas, lalu lakukan paging bila perlu. Praktik ini terdengar sepele, tapi berdampak besar pada latensi aplikasi mobile.
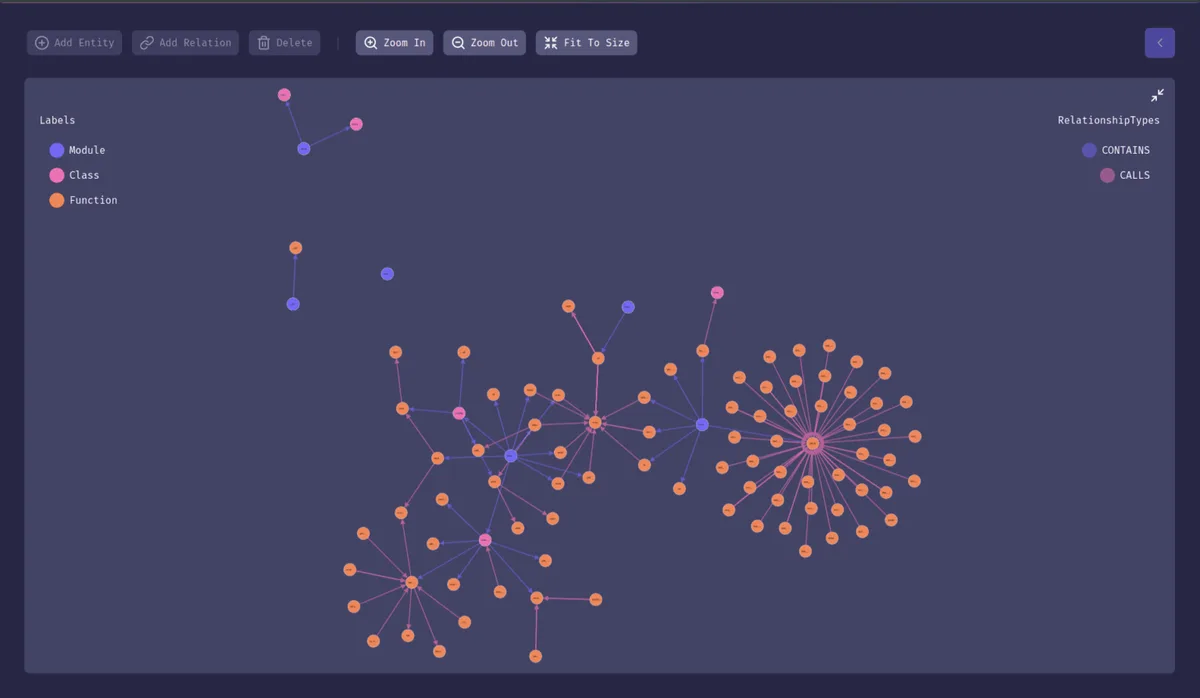
Membaca Response dan Menavigasi Relasi
Response umumnya berisi array entitas, masing-masing dengan properti seperti nama, deskripsi singkat, tipe, dan daftar relasi. Relasi inilah yang membuat graf bernilai: dari satu entitas, Anda bisa melompat ke entitas terkait untuk membangun rekomendasi.
Contoh nyata di lapangan: sebuah portal berita memakai relasi “sameAs” untuk menggabungkan profil tokoh dari berbagai sumber. Hasilnya, halaman profil jadi lebih kaya dan pengguna betah lebih lama. Kunci utamanya terletak pada konsistensi ID entitas antarsumber.
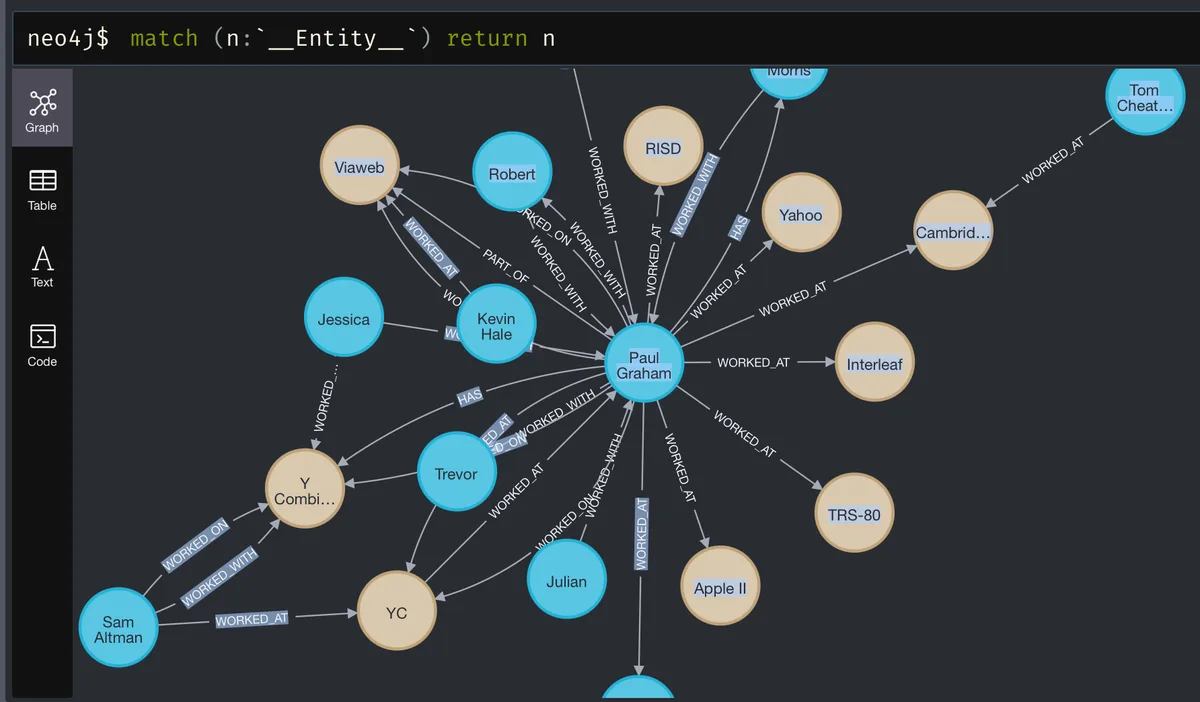
Komponen Utama dalam Knowledge Graph Search API
Setiap knowledge graph search API yang matang terdiri dari beberapa komponen yang saling menopang. Mengenali komponen ini memudahkan Anda menilai kualitas sebuah layanan sebelum memutuskan memakainya.
Komponen pertama knowledge graph search api adalah skema atau ontologi, yaitu kesepakatan tentang tipe entitas dan relasi yang diizinkan. Tanpa skema yang rapi, graf akan berantakan dan sulit di-query. Komponen kedua adalah indeks pencarian yang memungkinkan pencocokan cepat terhadap jutaan entitas.
Komponen ketiga adalah mesin query graf, sering memakai bahasa seperti SPARQL atau Cypher di balik layar. Terakhir, ada lapisan API dan autentikasi yang mengatur siapa boleh mengakses apa, berapa kuota per detik, dan bagaimana data disajikan.
Ontologi dan Skema Data
Ontologi menentukan “kosakata” graf Anda. Misalnya, apakah relasi antara film dan sutradara dinamai “directedBy” atau “director”? Kesepakatan ini penting agar aplikasi tidak salah tafsir.
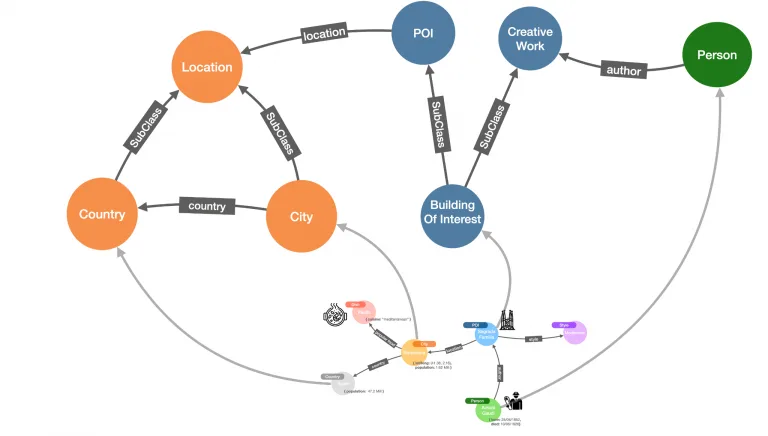
Dalam praktik, banyak tim meminjam ontologi publik seperti Schema.org untuk mempercepat adopsi. Ini juga memudahkan interoperabilitas dengan sumber data eksternal yang memakai standar serupa.
Indeks dan Mesin Pencocokan Entitas
Pencocokan entitas adalah jantung pengalaman pencarian. Pengguna mengetik nama yang ambigu atau salah eja, dan sistem harus tetap menemukan entitas yang dimaksud. Teknik yang lazim dipakai mencakup normalisasi teks, pencocokan fuzzy, dan embedding semantik.
Sejujurnya, bagian ini paling sering diabaikan pemula. Mereka fokus pada tampilan hasil, padahal akurasi pencocokan entitas yang menentukan apakah fitur terasa pintar atau justru membingungkan.
Panduan Knowledge Graph Search API untuk Pemula
Bagi yang baru mulai, panduan knowledge graph search API yang baik harus menjelaskan langkah pertama tanpa mengasumsikan Anda sudah ahli. Berikut alur yang saya sarankan berdasarkan pengalaman mendampingi developer junior.
Mulailah dengan menentukan kasus penggunaan yang sempit, misalnya melengkapi profil tokoh di aplikasi Anda. Setelah itu, pilih penyedia API yang dokumentasinya jelas dan punya playground untuk uji coba. Jangan langsung menulis kode integrasi sebelum Anda memahami bentuk responsnya.
Langkah Awal Uji Coba di Playground
Hampir semua penyedia menyediakan konsol interaktif. Di sana Anda bisa mengirim query, melihat respons mentah, dan menguji berbagai parameter tanpa menulis satu baris kode. Manfaatkan fase ini untuk mengenali pola respons dan pesan error.
Catat beberapa query yang paling sering muncul di aplikasi Anda, lalu uji semuanya di playground. Ini membantu Anda memetakan kasus tepi—misalnya entitas dengan nama sama—sebelum masuk ke tahap integrasi.
Integrasi Pertama ke Aplikasi
Setelah paham bentuk respons, mulailah dengan integrasi minimal: satu endpoint, satu fungsi pemanggil, dan penanganan error yang rapi. Jangan langsung membangun caching kompleks sebelum alur dasarnya stabil.
Gunakan environment variable untuk menyimpan kunci API, dan batasi akses lewat backend agar kunci tidak bocor di sisi klien. Langkah kecil ini mencegah masalah keamanan yang mahal di kemudian hari.
Knowledge Graph Search API Lengkap: Fitur yang Wajib Diperhatikan
Saat mengevaluasi layanan, ada beberapa fitur yang membedakan knowledge graph search API lengkap dari yang sekadar cukup. Daftar berikut bisa jadi checklist Anda saat membandingkan penyedia.
Fitur pertama yang wajib ada adalah pencarian berbasis tipe dan filter. Tanpa ini, hasil akan terlalu luas dan sulit dipakai. Fitur kedua adalah dukungan multibahasa, penting jika aplikasi Anda melayani pengguna lintas negara.
Selanjutnya, perhatikan dukungan relasi bertingkat dan kemampuan ekspansi graf. Layanan yang baik memungkinkan Anda mengambil entitas beserta relasi satu atau dua tingkat sekaligus, tanpa harus memanggil API berulang kali.
| Fitur | Fungsi | Tingkat Kepentingan |
|---|---|---|
| Pencarian berbasis tipe | Menyaring hasil sesuai kategori entitas | Kritis |
| Dukungan multibahasa | Menampilkan label sesuai bahasa pengguna | Tinggi |
| Ekspansi relasi bertingkat | Menarik entitas terkait dalam satu panggilan | Tinggi |
| Paging dan kursor | Mengelola hasil dalam jumlah besar | Sedang |
| Rate limit transparan | Membantu perencanaan kapasitas | Sedang |
Dari tabel di atas, dua fitur teratas sering menjadi penentu. Menurut pengalaman, tim yang mengabaikan filter tipe berakhir dengan hasil pencarian yang berisik dan pengalaman pengguna yang buruk.
Knowledge Graph Search API Terbaru: Tren dan Standar yang Berkembang
Lanskap knowledge graph search API terbaru bergerak ke arah pencarian semantik yang lebih pintar. Salah satu tren yang paling terasa adalah pemanfaatan embedding untuk mencocokkan makna, bukan hanya string.
Pendekatan knowledge graph search API ini membuat pencarian lebih toleran terhadap variasi bahasa dan salah eja. Selain itu, semakin banyak penyedia mengekspos endpoint bergaya GraphQL yang memberi klien kendali lebih besar atas bentuk respons.
Standar lain yang menguat adalah penggunaan Schema.org sebagai basis ontologi. Ini memudahkan integrasi lintas sistem dan mempercepat waktu pengembangan, karena developer tidak perlu merancang kosakata dari nol.
Pencarian Semantik Berbasis Embedding
Embedding mengubah entitas dan query menjadi vektor angka, lalu mencocokkan keduanya berdasarkan kedekatan makna. Hasilnya, query “presiden pertama Indonesia” bisa menemukan entitas Soekarno meski tidak ada kata “Soekarno” di dalamnya.
Teknik ini sangat berguna untuk aplikasi percakapan. Pengguna menulis dengan bahasa bebas, dan sistem tetap bisa menemukan entitas yang relevan tanpa harus menebak kata kunci persis.
Interoperabilitas Antar Sumber Data
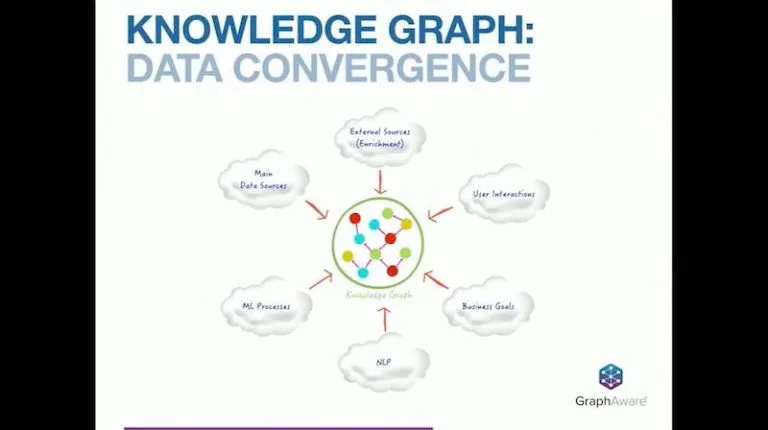
Graf pengetahuan jarang berdiri sendiri. Banyak organisasi menggabungkan data internal dengan sumber publik, dan di sinilah standar terbuka berperan penting. ID entitas yang konsisten dan ontologi bersama menjadi kunci.
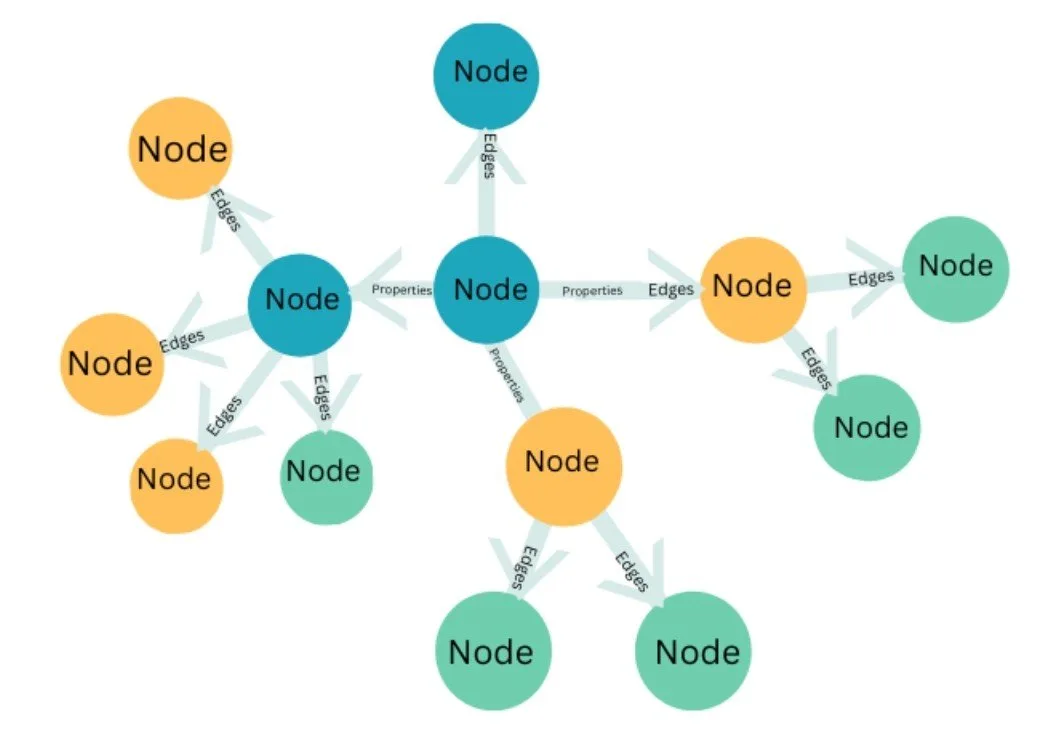
Praktik baiknya, simpan pemetaan ID antarsumber dalam tabel tersendiri. Ketika terjadi perubahan di satu sumber, Anda bisa melacak dampaknya tanpa membongkar seluruh integrasi.
5 Tips Mudah Mengoptimalkan Knowledge Graph Search API
Inilah inti dari judul yang Anda baca: lima tips yang bisa langsung diterapkan. Setiap tips saya susun dari kendala nyata yang kerap muncul saat tim mengintegrasikan knowledge graph search API ke produk mereka.
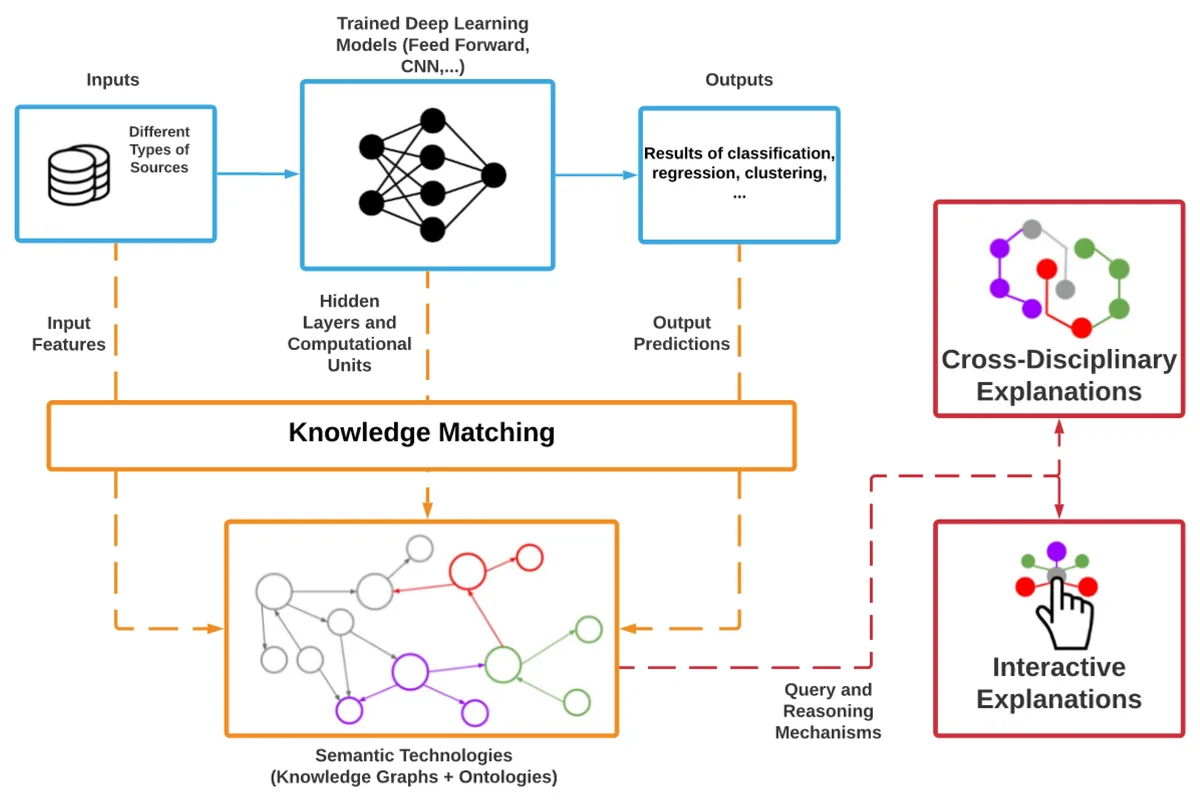
Tips-tips ini tidak menuntut arsitektur rumit. Sebagian besar justru soal kebiasaan kecil yang konsisten—dan itulah yang membuat perbedaan besar dalam jangka panjang.
Tips 1: Selalu Filter Berdasarkan Tipe Entitas
Nama entitas di dunia nyata penuh ambiguitas. “Mercury” bisa berarti planet, elemen kimia, atau merek mobil. Tanpa filter tipe, hasil pencarian Anda akan campur aduk dan membingungkan pengguna.
Solusinya sederhana: sertakan parameter tipe di setiap request. Jika tipe belum diketahui, tampilkan pilihan kategori ke pengguna, lalu kirim request kedua dengan filter yang dipilih. Pendekatan dua langkah dalam knowledge graph search API ini terbukti menurunkan tingkat kesalahan pencocokan secara signifikan.
Tips 2: Terapkan Caching Cerdas untuk Entitas Populer
Sebagian entitas jauh lebih sering dicari daripada yang lain—misalnya tokoh terkenal atau merek besar. Menyimpan hasil query untuk entitas populer di cache lokal bisa memangkas latensi drastis.
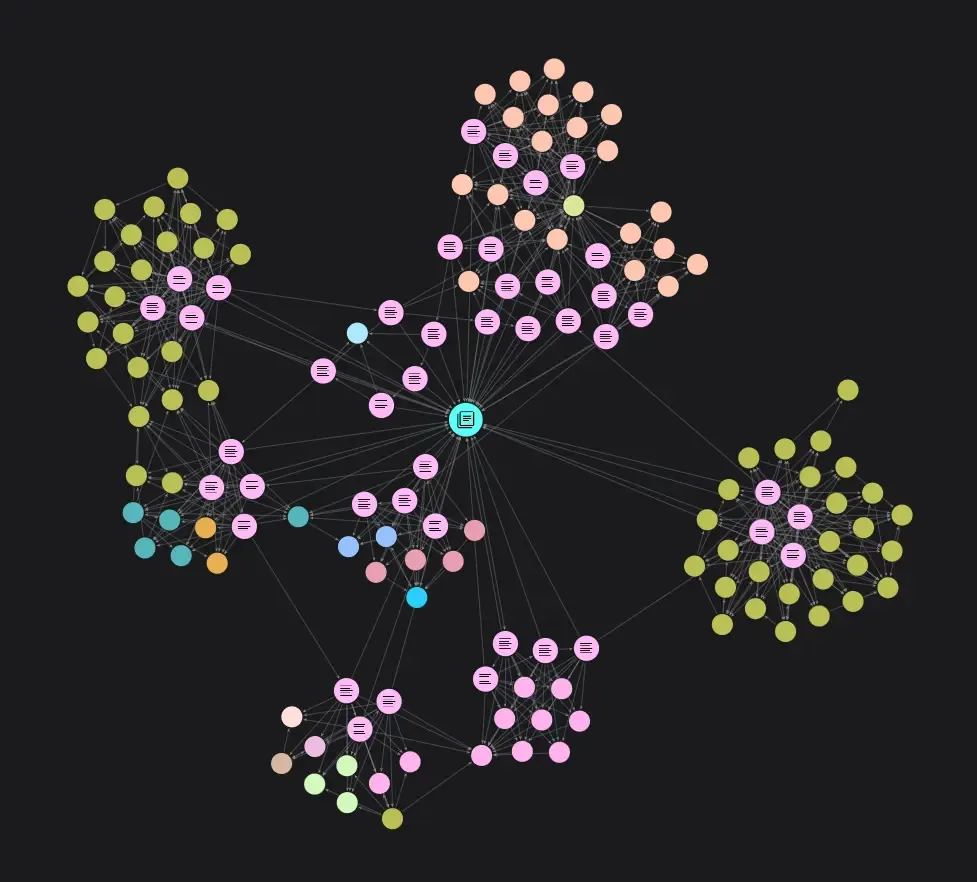
Kuncinya, tetapkan masa berlaku cache yang wajar dan sediakan mekanisme invalidasi. Data graf memang berubah, tapi tidak setiap detik. Cache selama beberapa jam untuk entitas stabil adalah kompromi yang masuk akal.
Tips 3: Gunakan Paging dan Batasi Jumlah Hasil
Menarik ratusan hasil sekaligus jarang bermanfaat. Pengguna biasanya hanya melihat 10-20 hasil teratas, jadi batasi request Anda pada jumlah itu dan gunakan kursor untuk melanjutkan.
Praktik knowledge graph search API menghemat bandwidth, mengurangi beban server, dan mempercepat waktu render di perangkat mobile. Dalam skenario penerapan sehari-hari, perubahan kecil ini sering menjadi perbaikan performa yang paling terasa.
Tips 4: Rancang Penanganan Error dan Fallback
API eksternal bisa gagal kapan saja: kuota habis, jaringan putus, atau server sedang bermasalah. Aplikasi Anda harus tetap berjalan meski data graf tidak tersedia.
Sediakan fallback, misalnya menampilkan data minimal dari cache atau menyembunyikan panel graf sementara. Sertakan juga retry dengan backoff eksponensial untuk error sementara. Pengalaman pengguna yang mulus lebih penting daripada kelengkapan data sesaat.
Tips 5: Pantau Kualitas Pencocokan Secara Berkala
Akurasi pencocokan entitas bisa menurun seiring bertambahnya data atau berubahnya pola pencarian pengguna. Karena itu, pantau metrik kualitas secara rutin, misalnya persentase query yang berhasil menemukan entitas yang tepat.
Kumpulkan sampel query nyata, lalu evaluasi knowledge graph search API secara manual setiap periode tertentu. Dari situ Anda bisa menyetel ulang parameter pencocokan atau menambah alias entitas yang sering meleset.
Kesalahan Umum saat Memakai Knowledge Graph Search API
Selain tips di atas, ada beberapa kesalahan yang berulang kali saya temui. Mengetahuinya lebih awal bisa menghemat waktu debugging Anda.
Kesalahan pertama adalah menganggap graf selalu lengkap dan akurat. Kenyataannya, data bisa bolong, usang, atau bahkan keliru. Aplikasi yang baik menampilkan data graf sebagai pelengkap, bukan satu-satunya sumber kebenaran.
Kesalahan kedua adalah memanggil API di sisi klien tanpa pengamanan. Kunci API yang bocor bisa disalahgunakan pihak lain, dan tagihan Anda melonjak tanpa kendali. Selalu rutekan panggilan lewat backend.
Mengabaikan Batas Kuota dan Biaya
Setiap penyedia punya batas kuota yang berbeda. Mengabaikannya bisa membuat aplikasi berhenti tiba-tiba saat kuota habis di tengah jam sibuk. Rancang strategi penggunaan yang sadar kuota sejak awal.
Jika memungkinkan, negosiasikan paket dengan harga kompetitif langsung dari produsen atau penyedia layanan. Untuk kebutuhan volume besar, kesepakatan khusus biasanya lebih hemat daripada tarif standar.
Menganggap Semua Entitas Punya Skema Sama
Tidak semua entitas kaya atribut. Sebuah entitas mungkin hanya punya nama dan tipe, tanpa deskripsi atau relasi. Kode Anda harus siap menghadapi properti yang kosong tanpa error.
Gunakan pengecekan null yang rapi dan desain tampilan yang tetap enak dilihat meski data minim. Ini terdengar teknis, tapi berdampak langsung pada kualitas antarmuka.
Studi Kasus Penerapan Knowledge Graph Search API
Untuk memberi gambaran konkret, mari lihat beberapa skenario penerapan. Contoh-contoh ini saya rangkum dari pola yang umum dijumpai di lapangan.
Sebuah platform berita memakai API graf untuk melengkapi artikel dengan profil tokoh yang disebut. Hasilnya, pembaca bisa langsung melihat latar belakang tokoh tanpa meninggalkan halaman, dan waktu kunjungan pun meningkat.
Contoh lain datang dari sektor e-commerce. Tim katalog memakai API untuk menormalkan nama merek dan kategori produk, sehingga filter pencarian jadi lebih akurat dan tingkat konversi ikut membaik.
Penerapan di Mesin Rekomendasi
Mesin rekomendasi bisa memanfaatkan relasi graf untuk menyarankan konten terkait. Jika pengguna menonton film A, sistem bisa menelusuri relasi “same director” atau “same genre” untuk menemukan film B.
Pendekatan knowledge graph search API ini sering menghasilkan rekomendasi yang lebih relevan dibanding collaborative filtering murni, terutama untuk konten baru yang belum punya banyak data interaksi. Graf membantu mengatasi masalah cold start.
Penerapan di Asisten Percakapan
Asisten percakapan memakai API graf untuk menjawab pertanyaan faktual. Ketika pengguna bertanya tentang sebuah tempat, asisten menarik entitas tempat tersebut beserta atribut seperti lokasi dan jam operasional.
Tantangan terbesarnya adalah memetakan bahasa alami pengguna ke entitas yang tepat. Di sinilah kombinasi pencocokan semantik dan filter tipe berperan penting agar jawaban asisten tidak meleset.
Perbandingan Pendekatan: API Publik vs Graf Internal
Ada dua jalur umum saat ingin memakai graf pengetahuan: memakai API publik atau membangun graf internal sendiri. Keduanya punya trade-off yang perlu Anda timbang.
API publik menawarkan kemudahan dan cakupan data luas tanpa perlu memelihara infrastruktur. Namun, Anda bergantung pada kuota, harga, dan kebijakan penyedia. Graf internal memberi kendali penuh, tapi menuntut investasi waktu dan tenaga untuk membangun serta merawatnya.
| Aspek | API Publik | Graf Internal |
|---|---|---|
| Waktu implementasi | Cepat | Lama |
| Kendali data | Terbatas | Penuh |
| Biaya awal | Rendah | Tinggi |
| Perawatan | Ditanggung penyedia | Ditanggung tim sendiri |
| Cakupan data | Luas | Sesuai kebutuhan |
Menurut pengalaman, banyak tim memulai dengan API publik untuk memvalidasi ide, lalu membangun graf internal ketika kebutuhan sudah jelas. Pendekatan bertahap ini menghindari investasi besar di awal yang berisiko.
Pertanyaan Umum Seputar Knowledge Graph Search API
Berikut pembahasan mendalam dan aspek penting seputar Pertanyaan Umum Seputar Knowledge Graph Search API:
Apakah Knowledge Graph Search API Itu Berbayar?
Sebagian besar penyedia menawarkan kuota gratis terbatas untuk pengembangan, lalu mengenakan biaya berdasarkan volume penggunaan. Untuk kebutuhan produksi berskala besar, biasanya tersedia paket dengan harga kompetitif langsung dari penyedia.
Apa Bedanya dengan Pencarian Teks Biasa?
Pencarian teks mencocokkan kata, sedangkan knowledge graph search API mencocokkan entitas dan relasinya. Hasilnya lebih terstruktur dan akurat secara faktual, karena sistem memahami bahwa “Jakarta” adalah ibu kota, bukan sekadar kata.
Bahasa Query Apa yang Dipakai?
Di lapisan API, Anda umumnya mengirim request HTTP biasa dengan parameter. Namun di balik layar, penyedia bisa memakai bahasa query graf seperti SPARQL atau Cypher untuk mengambil data dari penyimpanan.
Apakah Data di Graf Selalu Akurat?
Tidak selalu. Data graf knowledge graph search API bisa mengandung kesalahan, entitas ganda, atau informasi usang. Karena itu, penting memvalidasi data kritis lewat sumber lain dan memantau kualitas pencocokan secara berkala.
Bagaimana Cara Memulai dengan Anggaran Terbatas?
Mulailah dari kuota gratis, fokus pada satu kasus penggunaan sempit, dan terapkan caching untuk entitas populer. Setelah manfaatnya terbukti, barulah pertimbangkan peningkatan paket sesuai kebutuhan nyata.
Langkah Lanjutan Setelah Menguasai Dasar
Setelah nyaman dengan dasar-dasarnya, Anda bisa mengeksplorasi topik turunan yang memperdalam kemampuan integrasi. Salah satunya adalah penggabungan entitas dari berbagai sumber untuk membangun profil yang lebih kaya.
Topik lain adalah evaluasi kualitas graf secara sistematis, termasuk pengukuran presisi dan recall pencocokan entitas. Ini penting ketika aplikasi Anda mulai bergantung pada data graf untuk keputusan bisnis.
Terakhir, pertimbangkan untuk mempelajari cara membangun pipeline pembaruan data agar graf internal Anda tetap segar. Kombinasi API publik dan graf internal yang dikelola baik sering menjadi arsitektur paling tangguh untuk jangka panjang.
Knowledge graph search API adalah alat yang kuat bila dipakai dengan pemahaman yang tepat. Lima tips di atas—filter tipe, caching cerdas, pembatasan hasil, penanganan error, dan pemantauan kualitas—adalah fondasi yang bisa Anda terapkan sejak hari pertama. Sisanya adalah iterasi dan pembelajaran dari data nyata di lapangan.