Cara Google Crawl Website: 3 Langkah Praktis untuk Pemula
Mempelajari cara Google crawl website adalah pintu masuk paling dasar bagi siapa pun yang ingin situsnya muncul di halaman pencarian. Tanpa proses crawl yang lancar, konten sebagus apa pun tak akan pernah terlihat oleh mesin pencari, apalagi oleh calon pembaca. Jadi mari kita bongkar tuntas, dari nol, dengan bahasa yang santai tapi padat isi.
Sebelum masuk ke langkah teknis, saya ingin jujur dulu: banyak pemilik situs baru panik ketika halamannya tak kunjung terindeks, padahal masalahnya sering sederhana—Google sama sekali belum tahu halaman itu ada. Itulah kenapa memahami mekanisme crawl jauh lebih penting daripada sekadar mengejar trik SEO instan. Artikel ini adalah bagian dari klaster topik besar seputar dasar-dasar SEO teknis, dan crawl adalah fondasi yang menopang seluruh bangunan di atasnya.
Apa Itu Crawling dan Kenapa Ini Fondasi Segalanya
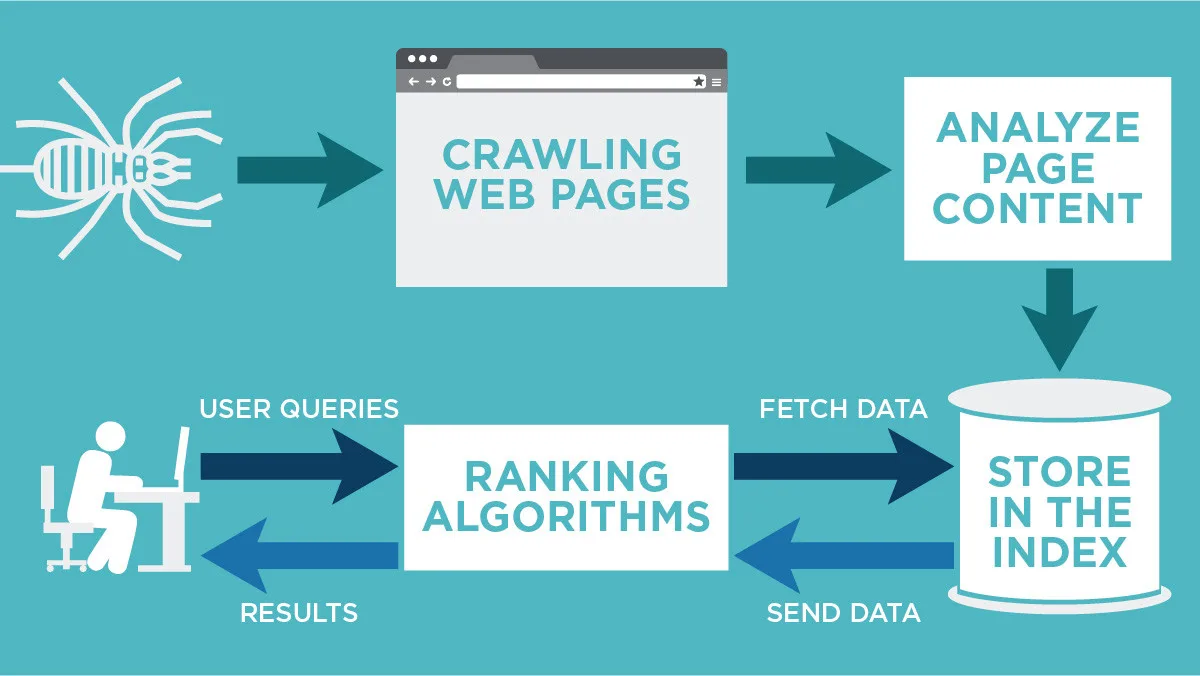
Crawling cara google crawl website adalah proses bot Google—dikenal sebagai Googlebot—menjelajahi internet dari satu tautan ke tautan lain untuk menemukan halaman baru atau yang diperbarui. Bayangkan Googlebot sebagai kurir yang berkeliling kota membaca setiap papan nama dan mencatat alamat yang belum pernah ia kunjungi. Tanpa kunjungan kurir ini, alamat Anda tak akan pernah masuk buku catatan pusat. Sebagai rujukan tambahan, Anda dapat membaca dokumentasi lengkap seputar cara google crawl website di ensiklopedia resmi.
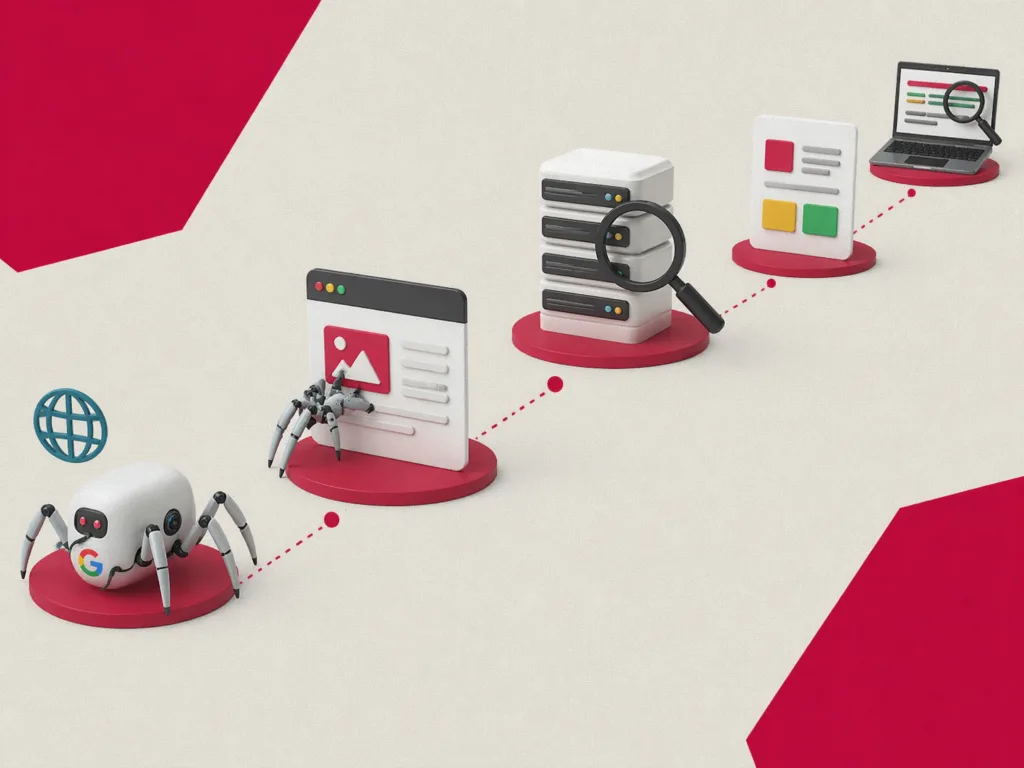
Setelah crawl selesai, halaman masuk ke tahap rendering dan indexing. Di sini Google membaca kode HTML, menjalankan JavaScript, memahami gambar, lalu memutuskan apakah halaman layak disimpan di basis data pencarian. Jadi kalau crawl gagal, dua tahap berikutnya otomatis tak akan pernah terjadi. Ini urutan yang tidak bisa dibalik. Untuk wawasan dan konteks tambahan, simak juga arsip panduan terkait kami.
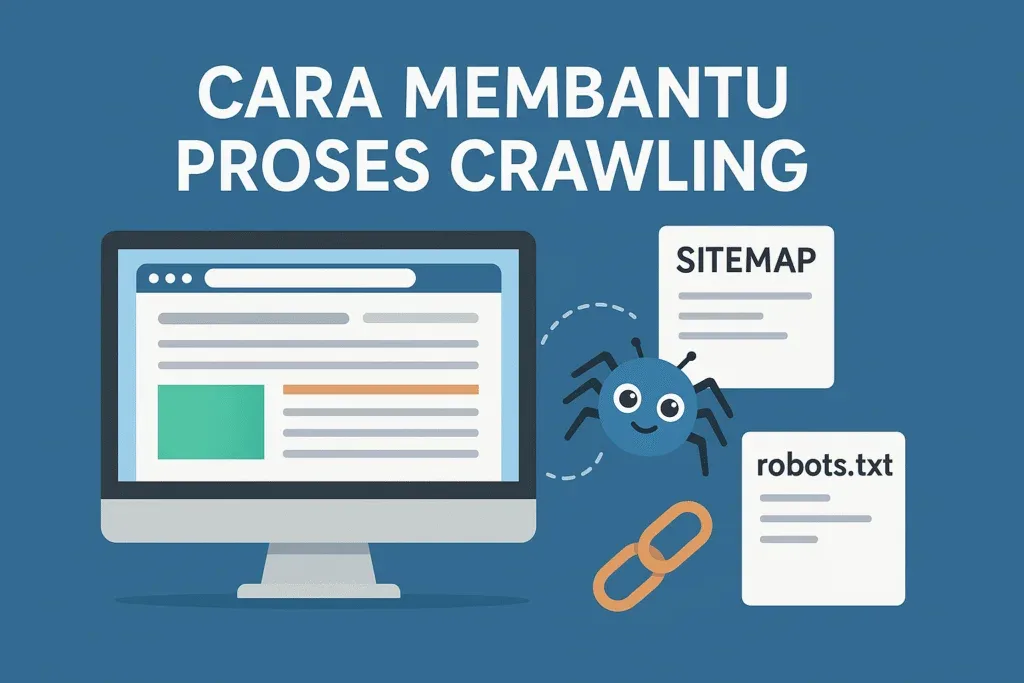
Menariknya, Googlebot tidak menjelajah sembarangan. Ia mengikuti tautan, membaca sitemap, dan memprioritaskan halaman berdasarkan otoritas serta seberapa sering konten diperbarui. Menurut pengalaman saya mengelola situs konten kecil, halaman yang rajin ditautkan dari halaman lain hampir selalu lebih cepat ditemukan ketimbang halaman yatim yang tak punya tautan masuk sama sekali. Itu bukan mitos, melainkan konsekuensi logis dari cara kerja bot.
3 Langkah Praktis Cara Google Crawl Website untuk Pemula
Judul artikel cara google crawl website menjanjikan tiga langkah, dan inilah realisasinya. Saya sengaja menyusunnya berurutan karena setiap langkah bergantung pada langkah sebelumnya. Kalau Anda melompati langkah pertama, dua langkah berikutnya akan terasa seperti menembak dalam gelap.
Langkah 1: Pastikan Google Tahu Website Anda Ada
Langkah paling awal dalam cara google crawl website untuk pemula adalah memastikan bot benar-benar menemukan keberadaan situs Anda. Ada dua jalur utama: menunggu Google menemukan tautan dari situs lain, atau memberi tahu langsung. Jalur kedua jauh lebih cepat dan bisa Anda kendalikan sendiri.
Caranya, buat file sitemap XML yang memuat daftar semua URL penting, lalu daftarkan lewat Google Search Console. Setelah terverifikasi, kirim sitemap di menu Sitemaps. Dalam hitungan hari—kadang jam—Googlebot mulai mengetuk pintu halaman Anda. Ini adalah tutorial google crawl website paling dasar yang wajib dikuasai sebelum menyentuh hal teknis lain.
Jangan lupa memeriksa file robots.txt. File ini adalah rambu lalu lintas yang memberi tahu bot halaman mana yang boleh dan tidak boleh dijelajahi. Kesalahan klasik pemula: menaruh baris Disallow: / tanpa sadar, yang artinya melarang seluruh situs untuk di-crawl. Saya pernah menemui kasus nyata di sebuah toko online kecil yang selama tiga bulan tidak terindeks gara-gara satu baris ini tertinggal dari masa pengembangan. Satu karakter salah, seluruh trafik hilang.
Selain itu, pastikan situs bisa diakses publik tanpa login. Halaman yang terkunci di balik autentikasi tidak akan pernah dibaca Googlebot. Sederhana, tapi sering terlewat.
Langkah 2: Rapikan Struktur Tautan dan Kecepatan Server
Setelah Google tahu situs Anda ada, langkah kedua dalam cara google crawl website step by step adalah memastikan bot bisa bergerak leluasa di dalamnya. Googlebot menemukan halaman baru terutama lewat tautan internal. Semakin rapi jaringannya, semakin mudah bot menjelajah.
Gunakan struktur tautan yang logis: dari beranda ke kategori, dari kategori ke artikel, dan antar artikel yang relevan saling menautkan. Hindari tautan yang rusak (404) karena bot membuang waktu mengunjunginya. Periksa juga apakah navigasi utama bisa diakses tanpa JavaScript berat—kalau menu baru muncul setelah skrip rumit dijalankan, ada risiko bot tidak sempat melihatnya.
Kecepatan server juga berpengaruh nyata. Googlebot punya batas waktu tunggu. Kalau server lambat merespons, bot bisa membatalkan kunjungan dan menunda crawl berikutnya. Dalam skenario penerapan sehari-hari, situs dengan waktu respons di bawah satu detik jauh lebih sering dikunjungi bot ketimbang situs yang butuh lima detik untuk membuka satu halaman. Ini bukan teori abstrak—crawl budget, yaitu jatah waktu dan tenaga yang dialokasikan Google untuk situs Anda, akan terbuang percuma kalau setiap kunjungan tersendat.
Untuk situs kecil dengan ratusan halaman, crawl budget biasanya bukan masalah besar. Tapi begitu Anda punya ribuan URL, termasuk halaman filter dan parameter pencarian yang tak berguna, alokasi ini mulai terasa. Solusinya, tandai halaman duplikat dengan tag canonical dan blokir parameter tak penting lewat robots.txt atau atribut noindex.
Langkah 3: Pantau, Verifikasi, dan Perbaiki
Langkah ketiga dari cara google crawl website adalah memantau hasilnya dan memperbaiki bila ada yang salah. Crawl bukan peristiwa sekali jadi—ia berulang terus selama situs Anda hidup. Karena itu, pengawasan rutin adalah bagian tak terpisahkan dari prosesnya.
Gunakan laporan “Page Indexing” di Google Search Console untuk melihat halaman mana yang sudah terindeks, mana yang ter-crawl tapi belum terindeks, dan mana yang diblokir. Fitur “URL Inspection” memungkinkan Anda memeriksa satu URL spesifik dan meminta crawl ulang secara manual. Ini sangat berguna setelah Anda memperbarui konten penting.
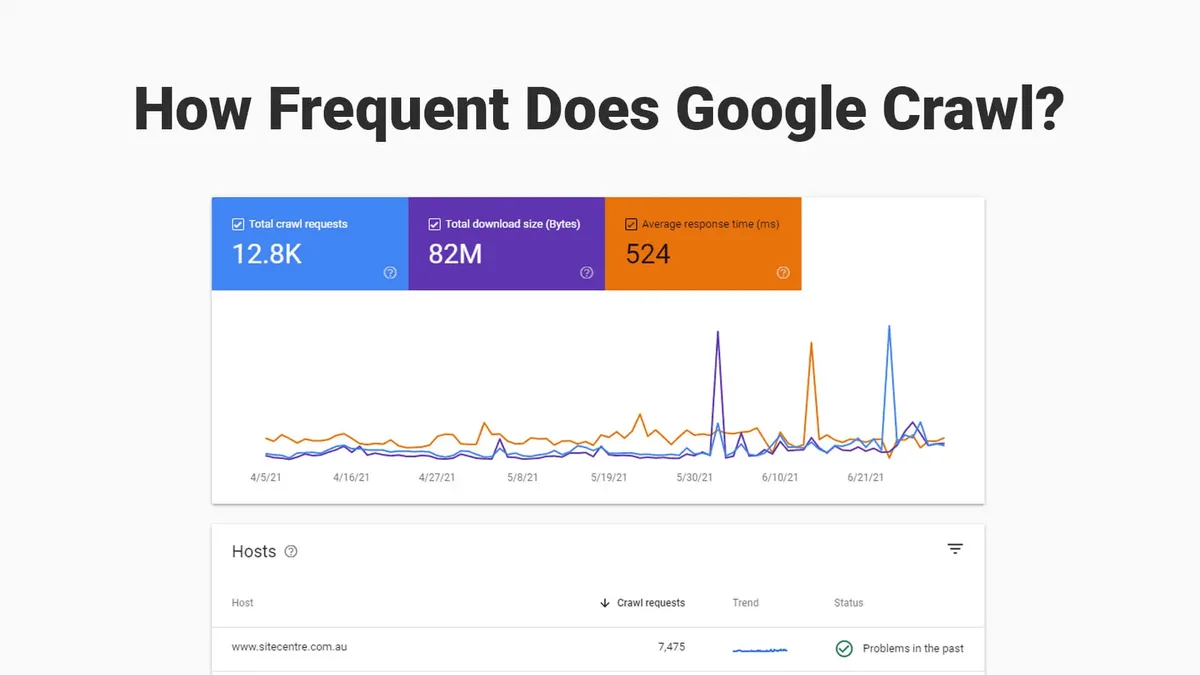
Perhatikan juga status respons server. Kode 200 berarti normal, 301 berarti pengalihan permanen, 404 berarti halaman hilang, dan 5xx menandakan masalah di server Anda. Kalau Googlebot sering menemui 5xx, ia akan mengurangi frekuensi kunjungan. Sebaliknya, situs yang stabil dan cepat diperbarui akan semakin sering dikunjungi.
Dari pengamatan saya, kesalahan paling umum yang muncul di laporan ini adalah “Crawled – currently not indexed”. Banyak pemilik situs langsung panik dan mengira ada yang rusak. Padahal sering kali artinya sederhana: kontennya dinilai belum cukup bernilai atau terlalu mirip dengan halaman lain. Perbaikannya cara google crawl website bukan teknis, melainkan kualitas isi.
Memahami Crawl Budget tanpa Harus Jadi Insinyur
Crawl budget cara google crawl website adalah istilah yang sering membuat pemula mundur teratur. Padahal konsepnya cukup sederhana: Google punya keterbatasan waktu dan sumber daya, jadi ia membagi perhatiannya ke miliaran situs di dunia. Untuk situs Anda, ada dua faktor penentu—kecepatan respons server dan seberapa sering konten berubah.
Situs berita yang memperbarui puluhan artikel per hari akan lebih sering di-crawl ketimbang situs profil perusahaan yang isinya statis berbulan-bulan. Itu wajar. Yang perlu Anda lakukan bukan memaksa bot datang lebih sering, melainkan memastikan setiap kunjungan yang datang benar-benar efisien. Artinya: tidak ada halaman duplikat, tidak ada tautan rusak bertebaran, dan tidak ada halaman tipis yang tak berguna.
Menurut pengalaman, salah satu perbaikan crawl budget paling berdampak adalah membersihkan parameter URL yang tak perlu. Situs e-commerce sering punya ribuan URL hasil filter warna, ukuran, dan urutan yang isinya nyaris sama. Googlebot bisa tersedot ke labirin ini dan kehabisan tenaga sebelum menyentuh halaman produk yang sebenarnya penting. Tandai versi kanonisnya, dan biarkan bot fokus ke yang bernilai.
Alat Bantu untuk Melacak Cara Google Crawl Website Terbaru
Anda tidak perlu menebak-nebak apakah Googlebot sudah berkunjung. Ada beberapa alat yang membantu memantau proses cara google crawl website ini secara langsung. Google Search Console adalah yang paling wajib—gratis dan resmi. Di sana Anda bisa melihat statistik crawl, mengirim sitemap, dan memeriksa status indeks per URL.
Untuk analisis lebih dalam, server log adalah sumber emas. Log server mencatat setiap kunjungan, termasuk dari Googlebot, lengkap dengan URL yang diakses dan kode responsnya. Dengan membaca log, Anda tahu persis halaman mana yang paling sering dikunjungi bot dan mana yang diabaikan. Alat seperti Screaming Frog juga berguna untuk memindai situs dari sudut pandang bot, menemukan tautan rusak, dan memeriksa tag canonical.
Selain itu, ada alat pihak ketiga yang menyajikan data crawl dalam tampilan lebih ramah. Tapi sejujurnya, bagi pemula, Search Console plus sedikit pembacaan log server sudah lebih dari cukup. Jangan tergoda mengumpulkan puluhan alat sebelum memahami dasar-dasarnya. Terlalu banyak data tanpa pemahaman justru membingungkan.
Yang penting diingat: cara google crawl website terbaru tidak berubah drastis dari prinsip dasarnya. Alat boleh berganti nama dan antarmuka, tapi logika bot tetap sama—menemukan tautan, merayapi, merender, lalu mengindeks. Kuasai prinsipnya, dan alat apa pun akan mudah Anda pakai.
Tabel Perbandingan: Sinyal yang Mempercepat vs Memperlambat Crawl
Supaya lebih gamblang, berikut rangkuman sinyal yang berpengaruh pada kecepatan dan kelancaran crawl. Tabel ini merangkum praktik yang saya temui di lapangan, bukan sekadar teori buku.
| Sinyal | Mempercepat Crawl | Memperlambat Crawl |
|---|---|---|
| Sitemap XML | Tersedia dan rutin diperbarui | Tidak ada atau berisi URL mati |
| robots.txt | Mengizinkan halaman penting | Memblokir seluruh situs tanpa sengaja |
| Kecepatan server | Respons di bawah satu detik | Respons lambat atau sering 5xx |
| Struktur tautan | Internal link rapi dan relevan | Halaman yatim tanpa tautan masuk |
| Kualitas konten | Unik, mendalam, diperbarui berkala | Duplikat, tipis, tak pernah berubah |
| Parameter URL | Bersih dan kanonis | Ribuan variasi filter tak berguna |
Dari tabel di atas, terlihat bahwa hampir semua sinyal bisa dikendalikan dari sisi Anda. Tidak ada yang benar-benar bergantung pada keberuntungan. Itu kabar baik, karena artinya proses crawl bisa Anda arahkan, bukan sekadar ditunggu.
Kesalahan Pemula yang Sering Menggagalkan Crawl
Setelah bertahun-tahun mengamati situs baru, saya menyimpulkan ada pola kesalahan yang berulang. Mengetahui pola ini lebih berharga daripada menghafal puluhan tips, karena Anda bisa langsung menghindarinya sejak awal.
Kesalahan pertama adalah mengandalkan JavaScript untuk seluruh konten. Kalau teks utama baru muncul setelah skrip berat dijalankan, ada risiko bot tidak sempat melihatnya dalam batas waktu rendering. Sajikan konten inti di HTML dasar, baru percantik dengan JavaScript. Prinsip ini berlaku untuk semua tahap dalam cara google crawl website.
Kesalahan kedua, menaruh tag noindex di seluruh situs karena salah konfigurasi plugin SEO. Ini sering terjadi saat migrasi atau penggantian tema. Selalu periksa ulang setelah perubahan besar. Kesalahan ketiga, cara google crawl website membuat tautan internal yang semuanya mengarah ke beranda, sehingga halaman dalam tak pernah ditemukan bot.
Kesalahan keempat yang tak kalah sering: mengabaikan pengalihan. Saat mengganti URL, jika tidak dipasang redirect 301, tautan lama menjadi 404 dan bot kehilangan jejak. Terakhir, kesalahan yang paling menyakitkan—memblokir Googlebot lewat robots.txt sambil berharap halaman tetap terindeks. Itu mustahil. Kalau diblokir, bot cara google crawl website tak akan pernah membacanya.
Pertanyaan yang Sering Muncul Seputar Crawl
Berikut pembahasan mendalam dan aspek penting seputar Pertanyaan yang Sering Muncul Seputar Crawl:
Berapa Lama Google Crawl Website Baru?
Tidak ada angka pasti, tapi untuk situs baru yang sitemap-nya sudah didaftarkan, crawl pertama biasanya terjadi dalam hitungan hari hingga dua minggu. Setelah itu, indexing bisa memakan waktu tambahan. Kalau lebih dari sebulan belum terindeks, periksa robots.txt, tag noindex, dan kualitas kontennya.
Apakah Crawl Sama dengan Indexing?
Beda. Crawl cara google crawl website adalah proses penemuan dan pembacaan halaman, sedangkan indexing adalah proses menyimpan halaman ke basis data pencarian. Halaman bisa ter-crawl tapi belum tentu terindeks. Perbedaan ini penting agar Anda tidak salah mendiagnosis masalah.
Bagaimana Memaksa Google Crawl Ulang Satu Halaman?
Gunakan fitur URL Inspection di Search Console, lalu klik “Request Indexing”. Cara ini meminta crawl ulang untuk satu URL spesifik. Lakukan setelah konten diperbarui signifikan, jangan berlebihan karena permintaan berulang tanpa alasan bisa diabaikan.
Apakah Backlink Membantu Proses Crawl?
Sangat membantu. Tautan dari situs lain adalah salah satu jalur utama Googlebot menemukan halaman baru. Semakin otoritatif sumber tautannya, semakin cepat dan sering halaman Anda dikunjungi. Inilah kenapa membangun tautan berkualitas tetap relevan.
Merawat Proses Crawl agar Tetap Sehat dalam Jangka Panjang
Setelah tiga langkah di atas dijalankan, tugas berikutnya adalah merawat. Crawl yang sehat bukan hasil sekali kerja, melainkan kebiasaan. Perbarui konten secara berkala, jaga kecepatan situs, dan bersihkan tautan rusak secara rutin. Ini bagian dari cara google crawl website yang sering dilupakan pemula setelah situsnya terindeks.
Buat jadwal pemeriksaan sederhana: sebulan sekali buka Search Console, cek laporan indeks, dan lihat apakah ada lonjakan error. Kalau ada, telusuri penyebabnya sebelum menumpuk. Situs yang dirawat rutin cenderung lebih dipercaya bot, dan itu berdampak langsung pada kecepatan konten baru ditemukan.
Ingat juga bahwa crawl adalah bagian dari klaster topik SEO teknis yang lebih luas. Setelah menguasainya, Anda bisa melanjutkan ke topik turunan seperti optimasi rendering, pengelolaan canonical, atau strategi internal linking. Ketiganya saling terkait dan akan memperkuat hasil dari langkah yang sudah Anda lakukan.
Cara google crawl website bukanlah ilmu rahasia. Ia bisa dipelajari siapa saja asal mau telaten. Mulai dari memastikan Google tahu situs Anda ada, merapikan struktur dan kecepatan, lalu memantau hasilnya. Tiga langkah itu, dijalankan konsisten, sudah cukup untuk membuat situs pemula bersaing sehat di hasil pencarian.