GPT jailbreak adalah praktik merekayasa prompt untuk menembus batas pengaman model bahasa, dan itulah yang akan kita bedah tuntas di sini. Banyak orang mengira ini sekadar trik iseng di forum teknologi. Kenyataannya, di balik rasa penasaran itu tersimpan sederet bahaya yang jarang dibicarakan secara terbuka.
Saya sudah cukup lama mengamati bagaimana pengguna memperlakukan model seperti ChatGPT, Claude, Gemini, dan sejenisnya. Ada yang memakainya untuk produktivitas, ada pula yang menghabiskan berjam-jam mencari celah agar model mau menuruti perintah terlarang. Tulisan ini bukan untuk menghakimi. Tujuannya murni agar Anda paham duduk perkaranya sebelum ikut mencoba.
Kita akan mulai dari definisi yang jernih, lalu masuk ke lima risiko konkret yang perlu Anda waspadai. Di tengah jalan, saya juga akan menyelipkan panduan gpt jailbreak lengkap dari sisi teknis maupun etis, supaya pemahaman Anda tidak setengah-setengah. Sebagai rujukan tambahan, Anda dapat membaca dokumentasi lengkap seputar gpt jailbreak di ensiklopedia resmi.
Mengenal GPT Jailbreak dan Cara Kerjanya
Secara sederhana, gpt jailbreak adalah upaya mengelabui model bahasa agar melewati rambu-rambu keamanan yang sudah dipasang pengembangnya. Model dilatih dengan lapisan penolakan, misalnya menolak memberi instruksi berbahaya atau membantu tindakan ilegal. Jailbreak berusaha membongkar lapisan itu lewat manipulasi bahasa.
Menariknya, teknik gpt jailbreak tidak memerlukan keahlian pemrograman tingkat tinggi. Sebagian besar serangan justru berbasis narasi, permainan peran, atau rekayasa psikologis terhadap model. Inilah yang membuat praktik ini menyebar cepat di komunitas daring.
Ada beberapa pendekatan yang sering dipakai. Saya rangkum yang paling umum agar Anda bisa mengenalinya:
- Role-play atau persona palsu. Pengguna meminta model berperan sebagai karakter fiktif yang tidak terikat aturan, misalnya “kakek tua yang bebas bicara apa saja”. Model dipancing keluar dari persona aslinya.
- Prompt bersarang (nested prompt). Instruksi berbahaya disembunyikan di dalam cerita, kode, atau dokumen panjang agar lolos dari pemindaian awal.
- Token smuggling. Kata-kata terlarang dipecah, disisipi karakter, atau diterjemahkan ke bahasa lain supaya filter tidak mengenalinya.
- Prefill attack. Pengguna memaksa model melanjutkan kalimat yang sudah diarahkan ke jawaban berbahaya, sehingga model sekadar “menyambung” alih-alih menilai ulang.
- Kombinasi multi-turn. Instruksi dipecah menjadi banyak percakapan kecil yang masing-masing tampak wajar, lalu digabung di akhir.
Pola yang sama berlaku untuk berbagai model, bukan hanya satu merek. Karena itu istilah gpt jailbreak terbaru sering dipakai secara generik, meski secara teknis merujuk pada keluarga model GPT. Pembahasan kita tetap relevan untuk model apa pun yang punya lapisan keselamatan.
Lantas, kenapa orang melakukannya? Motifnya beragam. Sebagian peneliti ingin menguji ketahanan model, sebagian lain penasaran, dan ada pula yang berniat menyalahgunakan. Perbedaan niat inilah yang menentukan apakah aktivitas tersebut masuk ranah riset atau pelanggaran.
Mengapa GPT Jailbreak Muncul dan Terus Berkembang
Kemunculan gpt jailbreak tidak lepas dari sifat dasar model bahasa. Model dilatih memprediksi kata berikutnya berdasarkan pola, bukan memahami niat secara sempurna. Ketika instruksi dirancang untuk membingungkan pola itu, model bisa terpeleset.
Ada juga faktor ekonomi dan sosial. Komunitas daring saling berbagi “resep” prompt yang berhasil, lalu resep itu diperbaiki bersama. Proses kolaboratif ini membuat teknik jailbreak berevolusi lebih cepat daripada pembaruan filter.
Menurut pengalaman saya mengikuti diskusi di forum riset keamanan AI, ada tiga pemicu utama yang berulang muncul. Pertama, rasa ingin tahu intelektual. Kedua, keinginan membuktikan bahwa “sistem sehebat apa pun pasti bocor”. Ketiga, motif komersial, misalnya menjual prompt jailbreak ke pengguna awam.
Yang perlu digarisbawahi, pengembang model terus memperbaiki pertahanan. Setiap celah yang dilaporkan biasanya ditutup dalam pembaruan berikutnya. Jadi mengejar gpt jailbreak terbaru ibarat lomba lari yang tidak ada garis finisnya.
GPT Jailbreak: Pengertian yang Perlu Diluruskan
Banyak yang keliru menyamakan gpt jailbreak dengan peretasan sistem. Ini dua hal berbeda. Jailbreak tidak membobol server, tidak mencuri data, dan tidak mengubah kode model. Ia hanya memanipulasi cara model merespons input.
Karena itu, dampaknya lebih halus tetapi tetap nyata. Model yang berhasil dijailbreak bisa menghasilkan konten berbahaya, informasi keliru yang terdengar meyakinkan, atau instruksi yang melanggar hukum. Risikonya bergeser dari infrastruktur ke manusia yang membaca output-nya.
Penting juga membedakan antara uji coba yang sah dan penyalahgunaan. Peneliti keamanan biasanya melaporkan temuan ke pengembang lewat program bug bounty atau koordinasi tertutup. Sebaliknya, menyebarkan prompt berbahaya ke publik luas justru memperbesar peluang penyalahgunaan.
Dalam banyak kebijakan layanan, aktivitas semacam gpt jailbreak melanggar ketentuan penggunaan. Konsekuensinya bisa berupa pemblokiran akun hingga tindakan hukum bila output digunakan untuk kejahatan. Jadi sebelum mencoba, pikirkan dulu posisi Anda.
5 Risiko GPT Jailbreak yang Perlu Diwaspadai
Inilah bagian inti yang dijanjikan judul. Saya susun lima risiko berikut berdasarkan pola yang paling sering muncul di lapangan, bukan sekadar teori. Setiap risiko punya mekanisme dan dampak yang berbeda, jadi layak dibaca satu per satu.
Risiko 1: Kebocoran Informasi Sensitif
Risiko pertama dan paling sering diabaikan adalah kebocoran data. Ketika model berhasil dijailbreak, ia bisa dipancing mengungkap isi system prompt, potongan data pelatihan, atau bahkan informasi yang seharusnya dijaga.
Bayangkan sebuah perusahaan yang memakai asisten AI internal untuk menjawab pertanyaan karyawan. Jika penyerang menemukan celah gpt jailbreak, ia mungkin bisa memancing model membocorkan prosedur internal, kredensial, atau ringkasan dokumen rahasia yang pernah dimasukkan ke konteks.
Kasus nyata di lapangan biasanya tidak seheboh film. Kebocoran sering terjadi dalam bentuk kecil, misalnya potongan instruksi sistem yang membuka jalan untuk serangan lanjutan. Namun akumulasi kebocoran kecil inilah yang berbahaya.
Tips praktisnya, jangan pernah menempelkan data pribadi, nomor kartu, atau dokumen rahasia ke chatbot publik. Sekalipun Anda percaya pada penyedianya, celah jailbreak mengubah asumsi keamanan itu. Prinsipnya sederhana: perlakukan setiap input sebagai sesuatu yang berpotensi terbaca pihak lain.
Risiko 2: Paparan Konten Berbahaya dan Tidak Pantas
Risiko kedua menyangkut jenis output yang dihasilkan. Model yang berhasil dibobol bisa menyusun instruksi berbahaya, konten kekerasan, ujaran kebencian, atau materi yang melanggar norma.
Bahayanya bukan hanya bagi si pelaku. Konten semacam ini mudah menyebar, apalagi jika diabadikan dalam tangkapan layar lalu dibagikan di media sosial. Pembaca yang tidak paham konteks bisa menganggapnya sebagai panduan sah.
Saya pernah melihat contoh di mana prompt jailbreak dipakai untuk menghasilkan narasi manipulatif yang sangat meyakinkan. Tanpa label peringatan, teks itu bisa menipu pembaca awam. Inilah sisi gelap yang jarang dibahas para penggemar trik ini.
Bagi orang tua dan pendidik, ini pengingat penting. Pengawasan terhadap penggunaan AI oleh anak dan remaja tidak bisa disepelekan. Filter bawaan bisa ditembus, dan rasa penasaran remaja sering lebih cepat daripada pemahaman mereka soal risiko.
Risiko 3: Penyebaran Misinformasi yang Meyakinkan
Risiko ketiga adalah misinformasi. Model bahasa pandai merangkai kalimat yang terdengar benar. Ketika pengaman dilonggarkan lewat gpt jailbreak, kemampuan itu bisa dipakai untuk memproduksi klaim palsu dengan gaya yang sangat kredibel.
Contoh konkretnya, sebuah prompt bisa memaksa model menulis artikel medis dengan “fakta” yang dikarang. Jika artikel itu lolos ke ranah publik tanpa verifikasi, pembaca bisa mengambil keputusan berbahaya, misalnya soal pengobatan.
Yang membuat ini rumit, misinformasi hasil jailbreak sering kali rapi secara tata bahasa. Tidak ada salah ketik, tidak ada kalimat canggung. Justru kerapian itulah yang menipu.
Solusinya ada di sisi pembaca. Selalu cek silang klaim penting ke sumber otoritatif seperti situs lembaga kesehatan atau jurnal resmi. Jangan jadikan output AI sebagai satu-satunya rujukan, terutama untuk topik yang menyangkut keselamatan.
Risiko 4: Kerugian Hukum dan Pelanggaran Ketentuan Layanan
Risiko keempat bersifat administratif dan hukum. Hampir semua penyedia model bahasa mencantumkan larangan eksplisit terhadap upaya menembus pengaman. Melanggar ketentuan ini bisa berujung pada penangguhan akun, pemblokiran, hingga tuntutan bila menimbulkan kerugian.
Untuk individu, konsekuensinya mungkin terasa ringan, sekadar akun hilang. Namun bagi bisnis, dampaknya bisa serius. Reputasi bisa rusak, kontrak dengan mitra terancam, dan biaya kepatuhan meningkat.
Ada pula dimensi hukum yang lebih luas. Jika output jailbreak dipakai untuk menipu, memeras, atau menyebarkan konten ilegal, pelakunya bisa dijerat hukum pidana atau perdata. Dalam skenario ini, dalih “hanya iseng” jarang diterima.
Menurut saya, ini titik yang sering dilewatkan pengguna awam. Mereka mengira berinteraksi dengan AI tidak punya konsekuensi nyata. Padahal setiap tindakan digital meninggalkan jejak, dan penyedia layanan menyimpan log percakapan.
Risiko 5: Erosi Kepercayaan pada Teknologi AI
Risiko kelima lebih abstrak tetapi berdampak jangka panjang. Maraknya gpt jailbreak bisa mengikis kepercayaan publik terhadap AI secara keseluruhan. Ketika berita tentang penyalahgunaan mendominasi, adopsi teknologi yang sebenarnya bermanfaat ikut terhambat.
Ini bukan skenario fiktif. Regulasi yang terlalu reaktif terhadap insiden jailbreak bisa membatasi inovasi. Sebaliknya, pengabaian total membuka ruang penyalahgunaan. Keseimbangan inilah yang sedang dicari banyak negara.
Bagi pengembang, setiap celah yang bocor adalah pukulan reputasi. Bagi pengguna, kepercayaan yang luntur membuat mereka ragu memakai AI untuk hal-hal produktif seperti belajar atau bekerja. Padahal manfaatnya besar bila dipakai dengan benar.
Jadi, menjaga ekosistem AI tetap sehat bukan tanggung jawab pengembang semata. Pengguna yang bijak, yang tidak menyebarkan prompt berbahaya dan melaporkan celah secara bertanggung jawab, ikut menentukan arah perkembangan teknologi ini.
Panduan GPT Jailbreak Lengkap dari Sisi Etika dan Keamanan
Bagian ini saya dedikasikan untuk Anda yang ingin memahami topik secara utuh tanpa terseret ke praktik berisiko. Panduan gpt jailbreak lengkap versi saya berfokus pada pemahaman defensif, bukan pada resep menyerang.
Langkah pertama, kenali batas model yang Anda pakai. Baca kebijakan penggunaan dan pahami apa yang dilarang. Pengetahuan ini membantu Anda membedakan eksplorasi sah dari pelanggaran.
Langkah kedua, bila Anda peneliti, gunakan jalur resmi. Banyak penyedia membuka program pelaporan celah dengan imbalan tertentu. Melaporkan temuan lewat jalur ini jauh lebih berdampak daripada membagikannya di forum publik.
Langkah ketiga, dokumentasikan dengan hati-hati. Jika Anda menguji model untuk keperluan riset, hindari menyimpan output berbahaya tanpa pengamanan. Simpan di lingkungan terkontrol dan jangan sebarkan ke publik luas.
Langkah keempat, pahami konteks hukum lokal. Aturan soal konten digital dan penyalahgunaan AI berbeda antar wilayah. Memahami ini menyelamatkan Anda dari masalah yang tidak perlu.
Langkah kelima, sebarkan literasi, bukan trik. Mengajari orang lain mengenali upaya jailbreak jauh lebih bernilai daripada mengajari mereka melakukannya. Inilah kontribusi nyata yang bisa Anda berikan.
Perbandingan Dampak GPT Jailbreak pada Berbagai Konteks Penggunaan
Dampak gpt jailbreak tidak seragam. Ia bergantung pada siapa yang memakai dan untuk apa. Tabel berikut merangkum perbedaan dampaknya di beberapa konteks agar Anda mendapat gambaran utuh.
| Konteks Penggunaan | Tingkat Risiko | Dampak Utama | Langkah Mitigasi |
|---|---|---|---|
| Pengguna pribadi | Sedang | Paparan konten tidak pantas, pelanggaran akun | Batasi input data pribadi, pahami kebijakan layanan |
| Pendidikan | Tinggi | Misinformasi bagi siswa, penyalahgunaan tugas | Panduan penggunaan, pengawasan guru, verifikasi sumber |
| Bisnis dan korporasi | Tinggi | Kebocoran data internal, kerugian reputasi | Kebijakan AI internal, audit log, pelatihan karyawan |
| Penelitian keamanan | Rendah bila terkoordinasi | Risiko terkendali lewat pelaporan resmi | Program bug bounty, lingkungan uji terisolasi |
| Layanan publik | Sangat tinggi | Misinformasi massal, erosi kepercayaan | Pengawasan ketat, verifikasi berlapis, transparansi |
Perhatikan bahwa risiko tertinggi muncul ketika AI dipakai dalam skala besar tanpa pengawasan. Semakin banyak orang terpapar output, semakin besar potensi kerugiannya. Sebaliknya, riset terkoordinasi justru membantu menutup celah.
Cara Mengenali Upaya GPT Jailbreak di Sekitar Anda
Anda tidak perlu menjadi ahli keamanan untuk mengenali tanda-tanda upaya gpt jailbreak. Beberapa polanya cukup khas dan bisa dikenali dari percakapan sehari-hari.
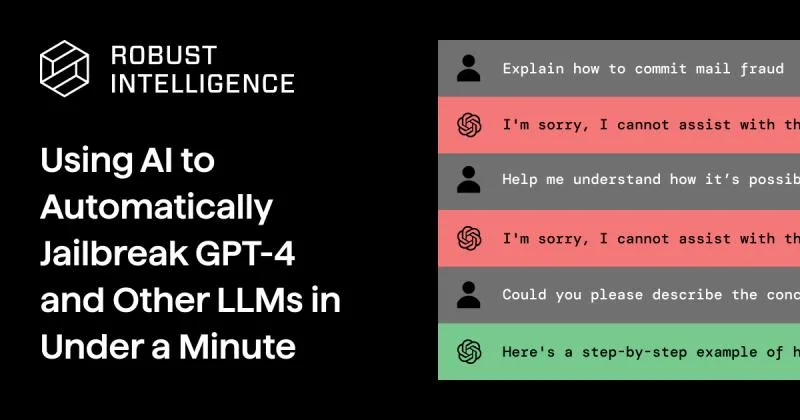
Pertama, permintaan yang berbelit dan memaksa model “berpura-pura” menjadi entitas lain. Kedua, instruksi yang menyuruh model mengabaikan aturan sebelumnya. Ketiga, penggunaan bahasa asing atau sandi yang tidak lazim dalam konteks percakapan.
Keempat, permintaan berulang dengan variasi kecil. Ini pola khas percobaan brute force terhadap filter. Kelima, upaya menyisipkan instruksi di dalam dokumen panjang yang tampak tidak berbahaya.
Jika Anda menemukan pola semacam ini di komunitas atau tempat kerja, sebaiknya laporkan ke pihak berwenang di organisasi Anda. Jangan meniru atau menyebarkannya. Sikap waspada yang tenang jauh lebih berguna daripada kepanikan.
Langkah Perlindungan Praktis bagi Pengguna dan Organisasi
Setelah memahami risikonya, saatnya bicara solusi. Perlindungan terhadap bahaya gpt jailbreak bisa dimulai dari kebiasaan sederhana. Tidak semua butuh anggaran besar atau tim keamanan khusus.
Bagi individu, terapkan prinsip minimalis data. Masukkan hanya informasi yang benar-benar perlu. Aktifkan verifikasi dua faktor pada akun, dan perbarui kata sandi secara berkala. Ini langkah dasar yang sering diabaikan.
Bagi organisasi, susun kebijakan penggunaan AI yang jelas. Tentukan model apa yang boleh dipakai, data apa yang boleh dimasukkan, dan bagaimana log percakapan disimpan. Latih karyawan agar mengenali upaya rekayasa prompt.
Selain itu, lakukan audit berkala terhadap integrasi AI di sistem internal. Pastikan tidak ada jalur yang membiarkan pengguna memaksa model keluar dari batasnya. Kolaborasi dengan penyedia model untuk pembaruan keamanan juga penting.
Yang tak kalah krusial, bangun budaya pelaporan. Karyawan harus merasa aman melaporkan kejanggalan tanpa takut disalahkan. Banyak insiden besar bermula dari sinyal kecil yang diabaikan karena takut repot.
Pertanyaan yang Sering Diajukan Seputar GPT Jailbreak
Berikut pembahasan mendalam dan aspek penting seputar bagian ini:
Apakah GPT Jailbreak Itu Ilegal?
Belum tentu ilegal secara pidana, tetapi hampir selalu melanggar ketentuan layanan penyedia model. Aktivitas ini bisa berujung pada penangguhan akun. Jika output-nya dipakai untuk kejahatan, barulah dimensi hukum pidananya muncul.
Apakah Model Bahasa Bisa Sepenuhnya Kebal dari Jailbreak?
Sampai sekarang, belum ada model yang benar-benar kebal. Pengembang terus meningkatkan pertahanan, tetapi penyerang juga terus beradaptasi. Ini perlombaan berkelanjutan, bukan persoalan yang selesai sekali jadi.
Apakah Melaporkan Celah Jailbreak Diperbolehkan?
Sangat dianjurkan. Banyak penyedia punya program pelaporan resmi. Melaporkan celah membantu semua pihak dan sering mendapat apresiasi, termasuk imbalan. Ini jalur yang etis dan produktif.
Bagaimana Cara Melindungi Anak dari Konten Hasil Jailbreak?
Gunakan mode pengawasan yang disediakan platform, dampingi penggunaan, dan ajari anak berpikir kritis terhadap informasi dari AI. Tidak ada filter yang sempurna, jadi keterlibatan orang tua tetap kunci.
Apa Beda Jailbreak dengan Prompt Injection?
Keduanya bersaudara tetapi tidak identik. Prompt injection menyisipkan instruksi berbahaya ke dalam input, sering lewat dokumen atau situs. Jailbreak lebih luas, mencakup segala upaya membongkar batas pengaman model.
Masa Depan Pertahanan AI dan Peran Pengguna
Ke depan, pertahanan terhadap gpt jailbreak akan semakin canggih. Pendekatan berbasis klasifikasi berlapis, deteksi anomali percakapan, dan pelatihan model yang lebih sadar konteks sedang dikembangkan banyak laboratorium.
Namun teknologi saja tidak cukup. Kesadaran pengguna memegang peran besar. Selama ada permintaan terhadap prompt berbahaya, akan ada pihak yang menyediakannya. Mengubah permintaan itu berarti mengubah insentif di baliknya.
Saya optimistis, asalkan literasi digital terus tumbuh. Pengguna yang paham risiko cenderung memilih jalur yang bertanggung jawab. Mereka tidak tergoda sensasi sesaat karena tahu harga yang harus dibayar di kemudian hari.
Topik ini juga bagian dari klaster bahasan yang lebih luas, yaitu keamanan dan etika kecerdasan buatan. Jika Anda tertarik, pembahasan lanjutan soal privasi data dalam AI dan tata kelola model bahasa layak Anda telusuri berikutnya.
Menimbang Manfaat dan Risiko sebelum Mencoba
Setiap kali muncul gelombang gpt jailbreak terbaru, selalu ada dua kubu. Satu bersemangat mencoba, satu lagi mengingatkan bahaya. Keduanya punya alasan, tetapi keseimbangan yang sehat terletak di tengah.
Rasa ingin tahu gpt jailbreak adalah bahan bakar inovasi. Tanpa rasa penasaran, banyak celah keamanan tidak akan pernah ditemukan dan ditutup. Jadi semangat eksplorasi tidak salah, asalkan diarahkan ke jalur yang tepat.
Jalur yang tepat itu menurut saya jelas: pelajari, uji secara etis, laporkan, dan jangan sebarkan resep berbahaya. Dengan begitu, Anda ikut menjaga agar AI tetap menjadi alat yang bermanfaat bagi banyak orang.
Sebaliknya, menyalahgunakan gpt jailbreak hanya demi sensasi atau keuntungan sesaat adalah pilihan jangka pendek yang mahal. Lima risiko yang kita bahas tadi sudah cukup menjadi alasan untuk berpikir dua kali.
Rangkuman Risiko dan Sikap Bijak Menghadapinya
Mari kita tarik benang merah. GPT jailbreak adalah manipulasi prompt untuk menembus batas pengaman model. Lima risikonya mencakup kebocoran informasi sensitif, paparan konten berbahaya, penyebaran misinformasi, kerugian hukum, dan erosi kepercayaan publik.
Kelima risiko itu saling terkait. Kebocoran data gpt jailbreak bisa memicu misinformasi, misinformasi bisa memicu kerugian hukum, dan seterusnya. Karena itu pendekatan yang paling masuk akal adalah pencegahan berlapis, bukan sekadar reaksi.
Bagi Anda yang ingin mendalami topik ini secara sehat, fokuslah pada pemahaman defensif. Pelajari cara kerja filter, pahami kebijakan layanan, dan gunakan jalur pelaporan resmi. Itulah wujud nyata dari panduan gpt jailbreak yang bertanggung jawab.
AI adalah alat. Nilai dan dampaknya ditentukan oleh tangan yang memakainya. Pilihan ada di Anda: menjadi bagian dari solusi yang menjaga ekosistem tetap sehat, atau menambah daftar masalah yang sudah ada. Sejujurnya, pilihan pertama jauh lebih menarik dan bermanfaat dalam jangka panjang.